
この記事でわかること
- TorchNeuronで既存のPyTorchコードがTrainiumで動くか。答えは、静的shapeの学習・推論ならモデルと入力のデバイス指定の変更で動く範囲が広い。ただし動的shape・sparse・NestedTensorなどは初回リリースで未対応です
- 上流テスト約15.4万件のスキップ内訳と、最大の群の約2.2万件が何の件数か(演算子の種類数ではない)
- Deepgramの『約60%』とTechCrunchの『70%』は、誰が何と比べて言った数字か
- 従来のPyTorch/XLA版torch-neuronxからの移行で、何に気をつけるか
- 日本のチームが試す前に確認すべきこと(対応インスタンス、国内リージョン、国内の利用例)
Amazon(AWS)は、自社のAIチップTrainium向けのPyTorchネイティブバックエンド「TorchNeuron」を、Apache 2.0のオープンソースとして公開ベータにしました。10月19日付のPyTorch公式ブログは公開ベータの開始を10月20日と案内しています。公開先はgithub.com/aws-neuron/torch-neuronxで、パッケージ名は従来のXLA版と同じtorch-neuronxを引き継ぎます。対象はTrainium2とTrainium3で、PyTorchのモデルを .to('neuron') でTrainiumに載せる方式です(PyTorch Blog 2026-10-19)。AWS公式リリースノート(Neuron 2.33.0)の Date of release は10/19/2026です(Neuron リリースノート、2026-10-20確認)。
『書き換え不要』が成り立ちやすいのは、静的なshapeで、BF16・FP32・FP16を使い、標準的な演算子と分散APIで書かれたコードです。ただし標準APIにもCPUフォールバックや非対応のものがあり、個別APIは公式の互換表で確認します(API互換表)。動的shapeやsparseテンソル、NestedTensor、forward-mode autogradは、AWS自身が初回リリースで対応しないと明記しています。float64はfloat32で実行されます(GitHub aws-neuron/torch-neuronx README、2026-10-20確認)。
1. 何が起きたか
TorchNeuronは、PyTorchが公式に用意しているカスタムハードウェア向けの拡張点「PrivateUse1」を使って、Trainiumを neuron という名前のデバイスとして登録します。公式ブログによると、torch.nn・torch.autocast・torch.distributed・torch.profiler が neuron デバイスでそのまま動きます(PyTorch Blog 2026-10-19)。
実行と最適化の選択肢は4つです。基本はeagerとtorch.compileで、adaptive eagerは実験的機能、NKIは両方から呼ぶカーネル開発手段という位置づけです。
| 選択肢 | 位置づけ(公式ブログの説明) | 状態 |
|---|---|---|
| eager | 演算を1つずつ即時実行。研究・デバッグ向け。演算ごとにNEFF(Neuronの実行ファイル)をコンパイルして起動。演算は初回使用時にコンパイルされ、以後キャッシュされる | 対応 |
| adaptive eager | 起動コストを減らし演算を融合して、コード変更なしでコンパイル済みグラフの性能に近づける | 実験的。既定でオフ、TORCH_NEURONX_ENABLE_CONCATENATION=1 で有効化 |
| torch.compile | TorchDynamo→AOTAutograd→Torch-MLIR経由でStableHLO→Neuronコンパイラ。本番向け | 対応(dynamic=False のみ) |
| NKI | Neuron Kernel Interface。独自カーネルを書き、eager・compileの両方から呼ぶ | 対応 |
コンパイル時はバックエンド名の指定が1回要ります。torch.compiler.set_default_backend("neuron") を一度呼ぶか、torch.compile(model, backend="neuron") と書きます。公式ブログの最小例は次の形です。
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
これは公式ブログの概略例です。実行時はモデルだけでなく入力テンソルも neuron へ配置し、損失関数が要求する教師データのデバイスも合わせる必要があります。AWSのリリースノートも、Trainium2/3で動かすにはモデルとその入力を neuron へ移すと説明しています。
Hugging Face Transformersでは device_map="neuron" を渡すか、device_map="auto" で自動検出されます。About Amazonは、同じ学習スクリプトを従来のチップとTrainiumで走らせ、違いはデバイス設定だけで学習の進み方も同じだったというデモを紹介しています。任意のモデルで同一の結果・速度を保証するものではありません(About Amazon、本文に日付表示なし・2026-10-20確認)。
2. 一次資料の対応表と、数字・日付の整理
| 主張・数字 | 一次資料 | 種別 | 確認日 |
|---|---|---|---|
| PrivateUse1で登録、eager・adaptive eager・torch.compile・NKI、Trainium2/3、10/20に公開ベータ(ブログの案内)、Apache 2.0 | PyTorch Blog(2026-10-19) | 公式ブログ | 2026-10-20 |
| 掲載手順は2.14.3.0.x Beta・PyTorch 2.14.0向け、Python 3.12〜3.14、Neuron SDK 2.33、Trn2/Trn3、静的shapeのみ、float64はfloat32で実行 | GitHub aws-neuron/torch-neuronx | GitHub | 2026-10-20 |
| torch-neuronx 2.13.3.0.(PyTorch 2.13.0)と2.14.3.0.(PyTorch 2.14.0)、Python 3.12〜3.14、Ubuntu 22.04はサポート終了、Date of release 10/19/2026 | Neuron リリースノート(Neuron 2.33.0) | 公式リリースノート | 2026-10-20 |
| PyTorch 2.9がPyTorch/XLAベースの最終版、2.10以降はTorchNeuron | Neuron公式告知(2025-12-16)(日付はRST版で確認) | 公式告知 | 2026-10-20 |
| 設定変更1つで既存コードが動く、Amazonの説明ではPyTorch利用者85%、ビルドごとに数十万モデルで検証 | About Amazon | Amazon公式広報記事 | 2026-10-20 |
| Deepgramが『1ドルあたり70%多くの音声を処理』(AWSのColin Brace氏の発言として) | TechCrunch(2026-10-19) | 報道(二次) | 2026-10-20 |
GitHubのREADMEによると、バージョン表記はPyTorchの版・torch-neuronxの版・ビルド番号の順で、2.14.3.0.4527 はPyTorch 2.14向けのtorch-neuronx 3.0、ビルド4527を意味します。README掲載の手順はPyTorch 2.14.0向けですが、公式リリースノートの対応表にはPyTorch 2.13.0向けの系列(2.13.3.0.*)もあり、Pythonはどちらも3.12〜3.14です。OSは、READMEがUbuntu 22.04/24.04/26.04とAmazon Linux 2023を挙げる一方、リリースノートの対応表ではUbuntu 22.04がサポート終了で、新規環境には24.04か26.04を使うよう案内しています。Amazon Linux 2023は対応表になく、資料間に不整合があります。2026-10-20時点でリポジトリのmainにはコミットが1件だけで、ReleasesとPackages欄は空でした。
3. 対応範囲と制約──テスト15.4万件のスキップ内訳
PyTorch公式ブログは、AWSが自分で実施したテストの数字を2種類載せています。どちらも開発元による測定です。
上流テストスイート(2026年8月実行分)
ATen・Dynamo・distributed・profilerの上流テストについて、ブログ本文は約15.4万件のテスト結果のうち約6.9万件を理由つきでスキップしたと説明しています。合格率は本文ではなくグラフ画像で示されており、読み取れる値は次のとおりです(上流テスト結果グラフ)。
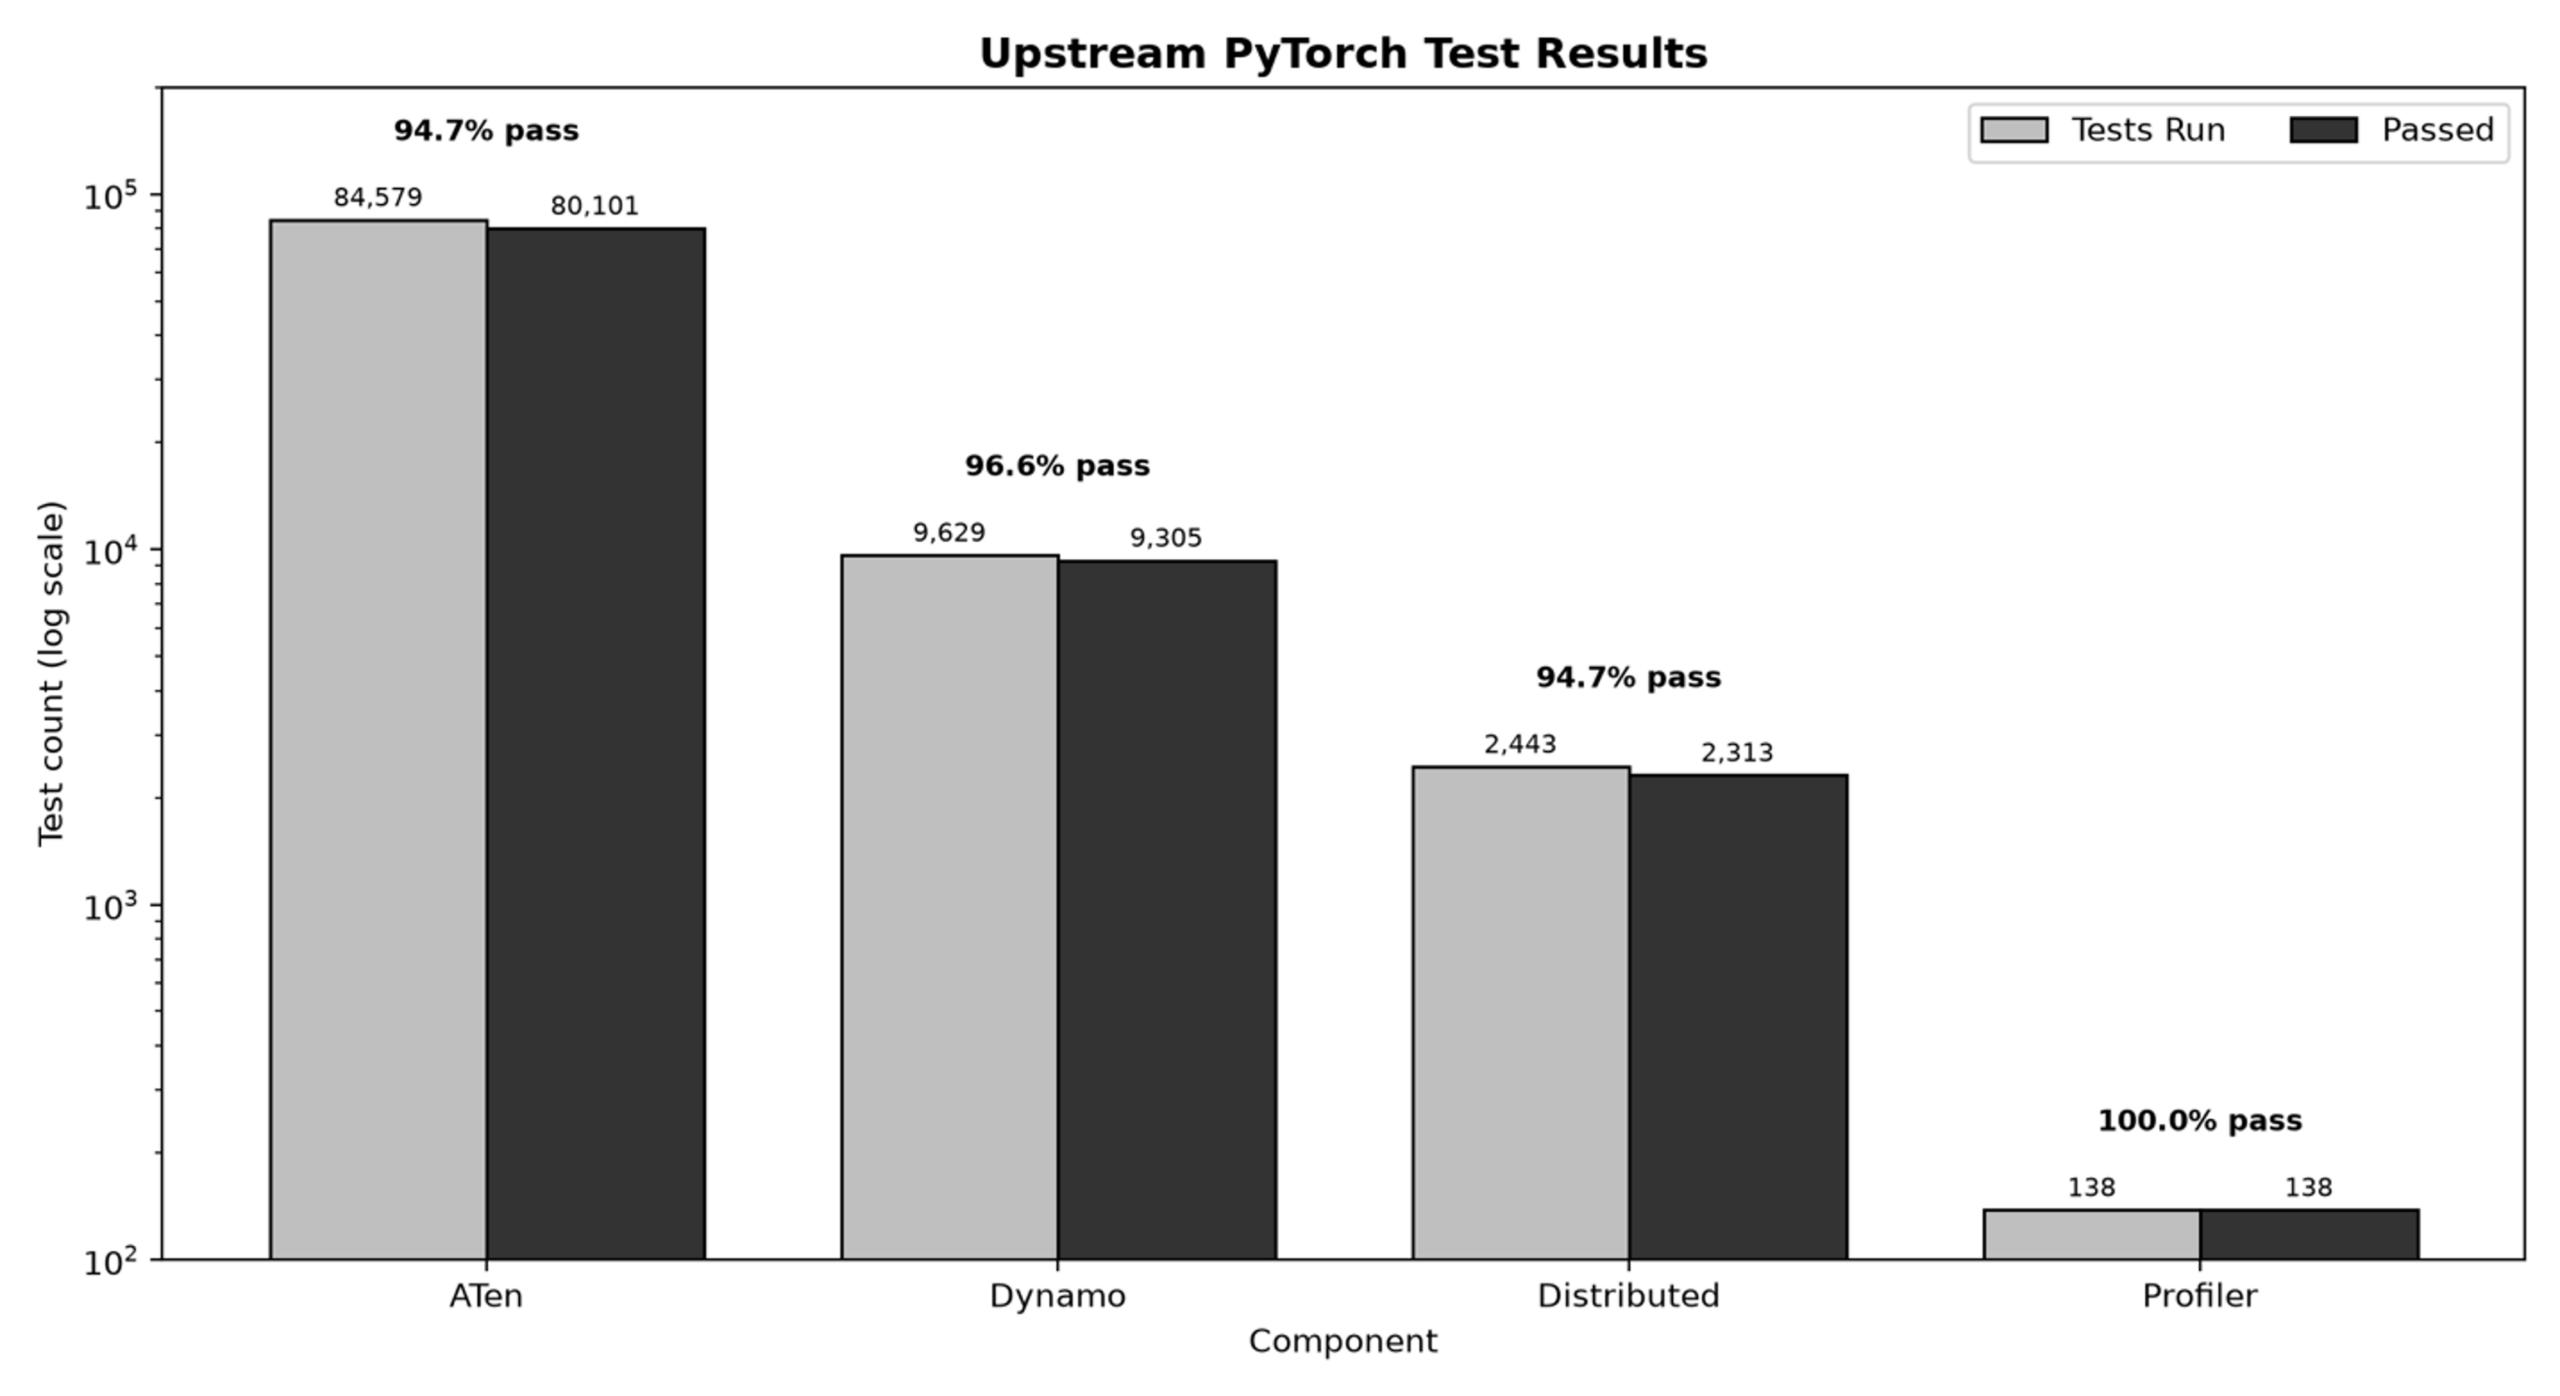
| 区分 | Tests Run | Passed | 合格率 |
|---|---|---|---|
| ATen | 84,579 | 80,101 | 94.7% |
| Dynamo | 9,629 | 9,305 | 96.6% |
| Distributed | 2,443 | 2,313 | 94.7% |
| Profiler | 138 | 138 | 100.0% |
グラフの実行件数(Tests Run)の合計は96,789件で、本文の概数を差し引いた約8.5万件とは一致しません。集計範囲の違いはブログに説明がないため、本記事では有効テスト数を確定しません。
スキップの内訳は次のとおりです。
| 区分 | 件数(公式ブログの概数) | 中身 |
|---|---|---|
| PyTorch側の適格性チェックによるスキップ | 約3万件 | CUDA専用・CPU専用テストなど。Neuron固有ではない |
| Neuronの意図的スキップ:ネイティブ実装のない演算に関連 | テスト約2.2万件(最大の群。演算子の種類数ではない) | 要素ごと演算・リダクション・foreach・高度なインデックス・高度な線形代数の端のケース、fused LSTM/GRUセル |
| Neuronの意図的スキップ:CUDA固有テスト | 本文テキストでは非記載 | CUDA graphs、NCCL固有の集団通信、CUDA固有のDynamo経路 |
| Neuronの意図的スキップ:初回リリースで非対応と決めた機能 | 本文テキストでは非記載 | 下の一覧 |
Neuronの意図的スキップは合計約3.9万件で、3群のうち本文で件数が示されているのは約2.2万件の群だけです(PyTorch Blog 2026-10-19)。約2.2万件はスキップされたテストの数で、演算子の種類数ではありません。ネイティブ実装がなくても動く演算はあり、リリースノートによるとeagerでは未対応の演算がCPUで実行されることがあり、torch_neuronx.get_fallback_ops() で記録を一覧できます。個別APIは、ネイティブ対応(Y)・CPUフォールバック(CPU_FALLBACK、CPUで実行するため遅い)・非対応(N)を分けた公式のAPI互換表で確認できます。
公式ブログが初回リリースで対応しないと挙げた機能は次のとおりです。理由は「顧客から要望がなかったため」と説明されています。
- 動的shapeとシンボリックshape
- sparseテンソルとsparse演算
- NestedTensor
- forward-mode autograd(JVP)
- ネイティブmulti-head attentionの任意のattentionマスク(マスクなしとcausalは対応)
- チャネルごとの量子化
- negative/conjugateのビュービット
- torch.signalの窓関数
- bilinear/bicubicのアップサンプル
- composite演算子の準拠性
個別APIの対応表示はこの一覧と差がある場合があるため、使うAPIは互換表で確認します。
READMEの「既知の制約」はさらに実務寄りです。torch.compileは静的shapeが前提で、入力shapeが変わるたびに再コンパイルされるため、パディングかバケット分けが勧められています。torch.compileでは連続(contiguous)なテンソルのみ対応で、非連続な入力は呼び出しごとにコピーされます。FlexAttentionは公式ブログでは『ネイティブ対応』とされる一方、READMEでは『限定的』です。torch.compileの mode は "default" だけで、Inductorのオプションは効きません。
型については、BF16・FP32・FP16と整数・真偽値型が使えます。TorchAOとFP8は非公開ベータ扱いで、次のリリースで一般提供予定とブログは書いています。READMEでも、MXFP8などの合成データ型のTorchAO統合はこのリリースでは使えないとしています。
Hugging Faceの10万モデル一括検証
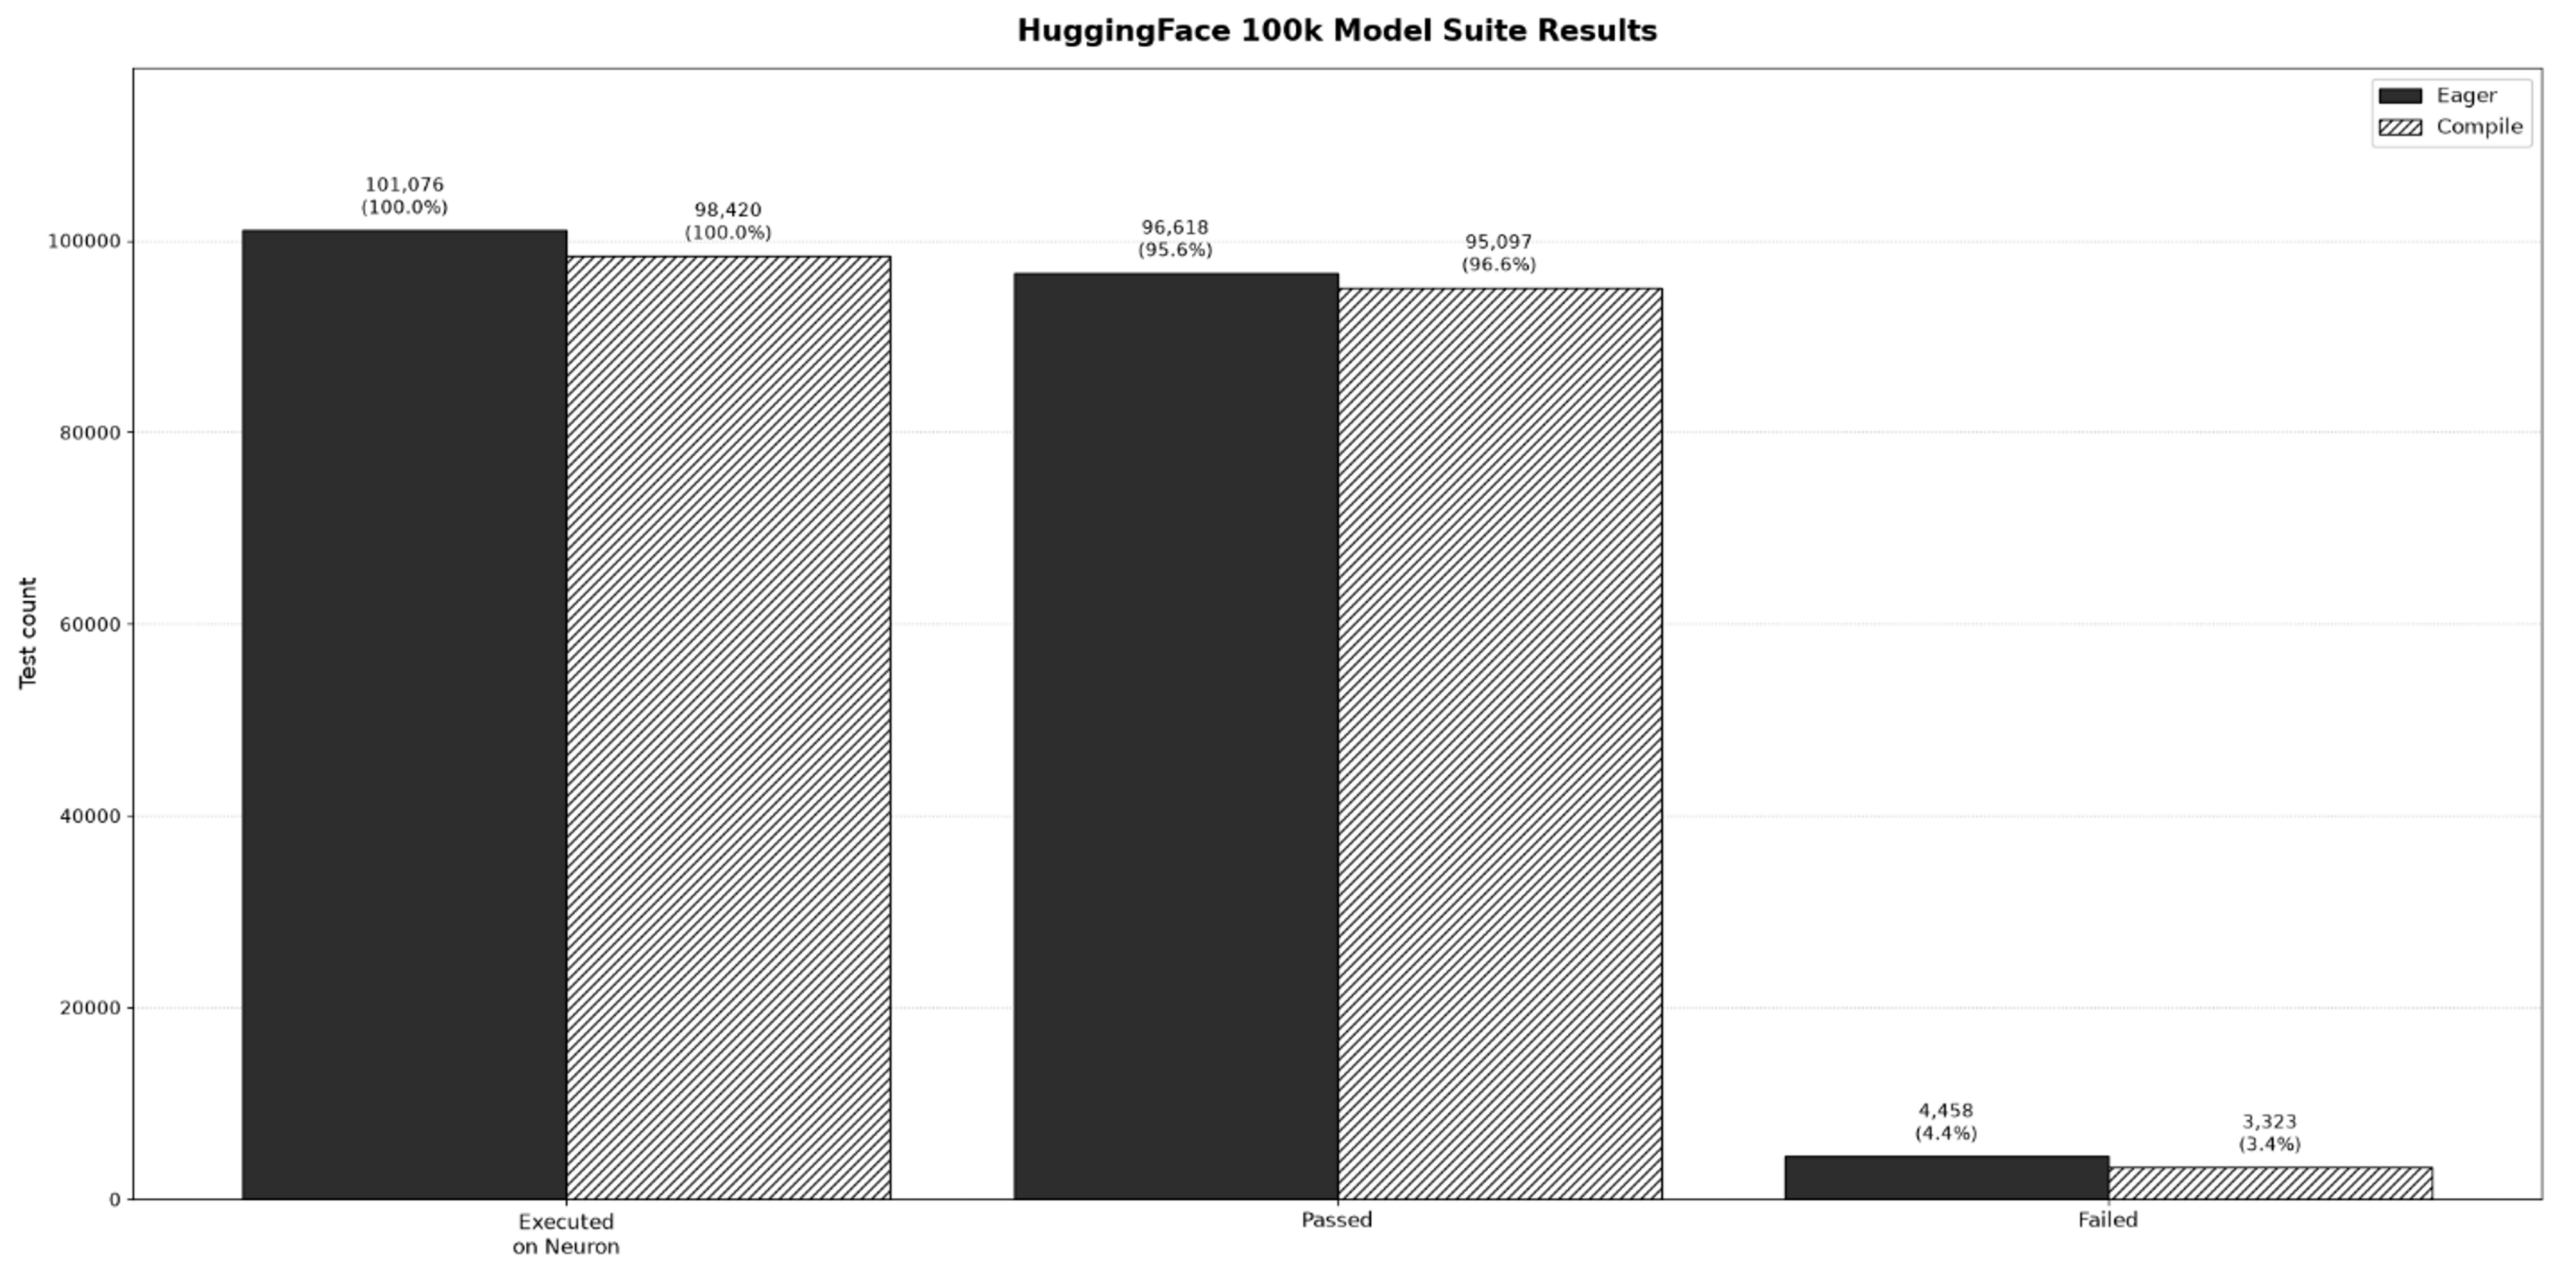
もう1つは、ダウンロード数ベースで実利用の99.9%をカバーするという10万モデルを、縮小した構成で継続的に走らせる検証です。ロード、forward・backward、コンパイルの可否とCPUフォールバックした演算子を記録しています。2026年9月時点のグラフでは、eagerは実行101,076件のうち96,618件合格(95.6%)、torch.compileは実行98,420件のうち95,097件合格(96.6%)です(10万モデル検証グラフ)。eagerとcompileで母数が異なるため、同一の10万モデルを全件成功させた結果とは読めません。ブログは残りの差を将来のリリースで『大半、できれば全部』埋めると書いています。
自分のコードが当たるかを見分けるには、上の一覧と互換表に照らすのが早道です。可変長の音声やテキストの推論は、torch.compileでは新しい入力shapeごとに再コンパイルが発生するため、パディングやバケット分けでコンパイル回数を抑えます。シンボリックな動的shape対応は初回リリースにありません。これとは別に、sparseな埋め込みやNestedTensorを使うattention実装は、初回リリースの非対応機能に当たるため回避策が必要です。
4. Deepgramの『約60%』と『70%』は何の数字か
PyTorch公式ブログに載ったDeepgramのCTO、Adam Sypniewski氏のコメントは次の内容です。AWS Generative AI Innovation Centerの支援を受け、数か月かけてモデルをTrainium上のPyTorch Nativeに移植しました。評価したベンチマークでは、Trainiumは既存のGPUベースラインより『1ドルあたり約60%多くの入力音声秒数を処理する』としています(PyTorch Blog 2026-10-19)。
一方、TechCrunchのJulie Bort氏の記事『Amazon is taking its biggest shot at Nvidia yet with new TorchNeuron dev tool』(2026年10月19日)は、Deepgramが『本番級の精度で1ドルあたり70%多くの音声を処理している』と書いています。これはAWS Annapurna LabsのColin Brace氏(VP of Technology Software)の引用符つきの発言として掲載されています(TechCrunch 2026-10-19)。
| 項目 | PyTorch公式ブログ | TechCrunch |
|---|---|---|
| 数字 | 約60% | 70% |
| 話者 | Deepgram CTO(顧客本人の署名つき引用) | AWS Annapurna LabsのColin Brace氏の直接引用(ベンダー側の発言) |
| 指標 | 1ドルあたりの入力音声秒数 | 1ドルあたりの音声処理量、本番級の精度で |
| 比較相手 | 既存のGPUベースライン | 記事中に明記なし |
顧客が自分の名前で出した数字は約60%で、70%は報道に掲載されたベンダー側の発言です。どちらが正しいかは公開資料からは決められません。
読み方の注意が2つあります。第一に、これは『同じ1ドルで処理できる量が約1.6倍』という意味です。コストに直すと、音声1秒あたりの費用は約1/1.6、つまり約37.5%下がる計算になります(70%なら約41%減)。第二に、比較相手のGPUの機種・世代・料金体系は公表されていません。Deepgramの1つのワークロードで、数か月の移植支援を経た結果です。
5. PyTorch/XLA版torch-neuronxからの移行
Neuronの公式告知(2025年12月16日)は、『PyTorch 2.9がPyTorch/XLAベースの最終版になる』とし、PyTorch 2.10以降はTorchNeuronによるネイティブ対応に移ると予告していました。PyTorch/XLAで学習している利用者には、TorchNeuronへの移行を勧めています(Neuron公式告知 2025-12-16)。
ややこしいのは、パッケージ名が同じ torch-neuronx のままである点です。READMEは、旧版はXLAベースの製品なので版指定を維持するよう案内しています。
以下は、対応するTrn2/Trn3上でNeuronドライバ・ランタイムなどのシステムパッケージを導入した後のPython環境設定です。READMEはNeuron DLAMIかDeep Learning Containerを推奨し、未導入なら公式Quickstartのシステム設定を先に行います。複数ノードではEFAの設定も要ります。README掲載の手順(PyTorch 2.14向け)は次のとおりです。
python3 -m venv ~/neuron_venv && source ~/neuron_venv/bin/activate
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
最後のコマンドの出力で device usable from torch が yes になれば準備完了です。
PyTorch 2.9以前の利用者が押さえる点は3つです。
- PyTorch本体の版が大きく上がる:XLA版の最終は2.9です。TorchNeuronは、README掲載手順がPyTorch 2.14.0向けで、公式リリースノートの対応表にはPyTorch 2.13.0向け系列(2.13.3.0.*)もあります。Pythonは3.12〜3.14です
- デバイスの扱いが変わる:PyTorch/XLAは
torch_xlaのAPIと遅延実行の方式でした。TorchNeuronはneuronデバイスに対するeager実行が基本で、本番性能はtorch.compileで取ります。XLA固有のAPI呼び出しは置き換えが要ります - 対応インスタンスがTrn2/Trn3に絞られる:READMEと公式ブログが挙げる対象はTrainium2とTrainium3だけで、第1世代のTrn1は対応表にありません
移行の詳細は、告知が案内する「Native PyTorch for AWS Trainium」の概要ドキュメントにあります。
6. 背景と競合──CUDA依存からどこまで離れられるか
TechCrunchは今回の発表を、NVIDIAのCUDAがPyTorchの事実上の標準環境になっている状況への挑戦と位置づけています。同時に、PyTorchはAMDのGPUやAppleのチップへもすでに設定変更で移せると指摘し、結果はまだわからないとしています。
公式ブログが挙げるエコシステム連携は次のとおりです。
- Hugging Face:Transformers・Diffusers・TRL・kernelsでTrainiumが上流のサポート対象デバイスになりました。Transformers v5をvLLM等のバックエンドにする構成の検証は「進行中」です
- TorchTitan:
torchtitan-neuronがNKIカーネルとTrainium向け設定を配布しています。trn2.48xlarge 8台でLlama 3 8Bを学習した損失曲線が掲載されています - vLLM:torch.compile対応の上に、LLM向けのvLLM Neuronと画像・動画生成向けのvLLM Omni Neuronがあります
- 分散学習:DDP・FSDP2・SimpleFSDP・テンソル並列・パイプライン並列、DTensorとDeviceMeshに対応し、ノード間はEFAで通信します
PyTorch側からは、MetaのJana van Greunen氏(PyTorchエンジニアリング・ディレクター)が、ハードウェアをまたぐ一貫した開発体験というPyTorchの方針に沿うとコメントしています。ブログの付録には、CUDA前提のハードコードを外すものを含め20件超のPyTorchとTorchTitanのPRが並んでいます。
CUDAからの脱却として現実的なのは、Hugging FaceやTorchTitanの標準的なモデルを、静的shapeで学習・推論するケースです。自前のCUDAカーネルはそのままでは使えません。標準演算への置き換えで済む場合もあり、残る部分はNKIで書くことになります。Cartesiaも、細かい演算はネイティブ経路で済んだ一方、繰り返し呼ばれてレイテンシを決める層はNKIカーネルを書いたと述べています。
7. 日本の読者への影響──リージョンと国内の利用例
国内リージョン:公式ブログ・About Amazon・README・AWSのTrn3製品ページは、提供リージョンに触れていません(2026-10-20確認)。Trn2の一般提供を告げた2024年12月のAWS発表は、当初の提供を米国東部(オハイオ)のCapacity Blocks経由としていました(AWS What’s New 2024-12-03)。AWS公式のEC2 Capacity Blocks for ML の対応表(2026-10-20確認)には東京(ap-northeast-1)の列がありますが、Trn2の欄にチェックはなく、大阪の列とTrn3の行はありません。trn2.48xlargeはオハイオとハイデラバード、trn2.3xlargeはメルボルンとサンパウロ、Trn2のUltraServerはオハイオです。この表は予約方式の対象で、一般提供地域の全体はこれだけでは判断できません。アカウントではaws ec2 describe-instance-type-offerings --location-type region --region ap-northeast-1 で trn2.* や trn3.* が返るかを見られますが、確認できるのは提供インスタンスタイプで、空き容量や予約可能枠は別途確認が必要です。
日本語対応・料金:TorchNeuron自体はオープンソースのライブラリなので、ライブラリの料金はかかりません。主な費用はEC2インスタンスなどAWSリソースの利用料です。日本語ドキュメントや日本円の料金について、今回の発表は触れていません。
国内の利用例:公式ブログの謝辞には、フィードバックをくれた組織としてKarakuriとRicohの名前があります。謝辞は設計への協力に対するもので、本番利用の意味ではありません。両社のTrainium利用は、2024年7月31日のAWS機械学習ブログ『Unlocking Japanese LLMs with AWS Trainium』で紹介されていました。Ricohはtrn1.32xlargeを64台(Trainiumチップ1,024個)使い、Llama 2 13B Chatをもとに日英バイリンガルの13BモデルLLMを学習しました。Karakuriはkarakuri-lm-70b-chat-v0.1を、カスタマーサポート向けチャットボットのために開発したと紹介されています(AWS Machine Learning Blog 2024-07-31)。Ricohの例は対応外の第1世代Trn1で、新しいスタックの実績ではありません。
8. 限界と未確定の点
- ベータである:READMEは2.14.3.0.xを「Beta」と明記しています。GAの時期は示されていません
- 合格率の数値は本文になくグラフ画像にある:上流テストと10万モデルの結果はグラフ画像で示され、本記事3章に転記しました。上流テストのグラフの実行件数合計と本文の概数は一致しません
- テストはすべて開発元による:15.4万件も10万モデルもAWSの測定で、今回確認した資料では第三者の再現結果を確認できませんでした
- TorchAO・FP8は次のリリース:Trn3の製品ページはMXFP8・MXFP4を挙げますが、TorchNeuronでの一般提供は次のリリース予定です
- 初回コンパイルが遅い:READMEによると初回呼び出しにコンパイル時間が含まれ、大きなモデルでは長くなります。2回目以降は永続キャッシュを再利用します
- Deepgramの数字の比較条件が非公開:GPUの機種と料金体系がわからないため、他社ワークロードへの当てはめはできません
- リージョン:国内提供は、公式の対応表・製品ページの範囲では未確認です。Capacity Blocksの対応表で東京のTrn2欄は空でした
9. よくある質問
TorchNeuronとは何ですか
AWSのAIチップTrainiumを、PyTorchの標準デバイスとして使えるようにするオープンソースのバックエンドです。Apache 2.0で、github.com/aws-neuron/torch-neuronxで公開されています。PyTorch公式ブログは2026年10月20日を公開ベータの開始日と案内しています。
Trn1やInferentiaでも使えますか
今回のREADMEと公式ブログが対象として挙げているのはTrn2とTrn3だけです。Trn1やInferentia系の記載はありません。
NVIDIAのGPUより安くなりますか
一般論としては言えません。公開されているのはDeepgramの1ワークロードの数字だけで、比較相手のGPUの条件は非公開です。自分のモデルで処理量あたりの費用を測る必要があります。
PyTorch/XLA版のtorch-neuronxはいつまで使えますか
Neuron公式告知は、PyTorch 2.9がXLAベースの最終版だとしています。XLA版のサポート終了日は、今回確認した告知には書かれていません。
自分のコードが動くかを最初にどう確かめればよいですか
collect_env で環境を確認し、まずeagerでモデルと入力を .to('neuron') へ移して走らせ、get_fallback_ops() でCPUに落ちた演算を見ます。次に torch.compile(model, backend="neuron", dynamic=False) で試し、入力shapeが変わるならパディングやバケット分けを入れます。そのうえで、3章の非対応機能と互換表に当たる箇所を確認します。
関連記事
- NVIDIAのHugging Face買収が8-Kで約束した『開いたまま』の射程 ── TorchNeuronが連携先に挙げるHugging Faceをめぐる、NVIDIA側の動き
- OpenAI Jalapeñoの『kWあたり』は公称TDPで正規化されている ── 独自AIチップの性能比較を、数字の分母から読む例
- Amazon×Anthropicの1,000億ドル契約が示すAI産業の新秩序 ── TorchNeuronの謝辞にも名前があるAnthropicとAWSの関係
まとめ
- TorchNeuronは、TrainiumをPyTorchのPrivateUse1デバイスとして登録するバックエンドで、PyTorch公式ブログの案内では2026年10月20日にApache 2.0の公開ベータになりました。対象はTrn2/Trn3です
- 『書き換え不要』が成り立ちやすいのは、静的shapeで標準的な演算子・分散APIを使うコードです。標準APIにもCPUフォールバックや非対応があり、個別APIは互換表で確認します。動的shape・sparse・NestedTensor・JVPなどは初回リリースで対応していません
- 上流テスト約15.4万件のうちスキップは約6.9万件で、Neuronの意図的スキップ約3.9万件の最大の群は、Neuronネイティブ実装のない演算に関連するテスト約2.2万件です(演算子の種類数ではありません)。グラフの実行件数合計96,789件は本文概数の差引と一致せず、有効テスト数は確定できません
- Deepgramの一次資料の数字は『1ドルあたり約60%多く処理』で、比較相手のGPUの条件は非公開です。70%はTechCrunchが伝えたAWS側の説明です
- 日本のチームが試す前には、国内リージョンでのTrn2/Trn3提供と、PyTorch 2.13または2.14・Python 3.12〜3.14、Ubuntu 24.04/26.04への移行コストを確認する必要があります