
何が起きたのか
DeepSeekが2026年8月21日、APIプラットフォーム上で実験版のマルチモーダルモデル deepseek-v4-flash-vision-exp を公開しました(DeepSeek API Docs Change Log 2026-08-21)。公式のリリースノートは、このモデルについて「テキスト能力はDeepSeek-V4-Flashと同等で、マルチモーダルのエージェントベンチマークではOpus-4.8に迫る」という位置づけを示しています(DeepSeek API Docs 2026-08-21)。
同時に公開されたのは、画像を1度アップロードして file_id で参照できる無料のFiles API、そして本モデルをそのまま扱えるDeepSeek Harness 0.1.1です(DeepSeek API Docs 2026-08-21)。料金表を見ると、deepseek-v4-flash-vision-exp の単価は deepseek-v4-flash とまったく同じ行に並んでいます(DeepSeek API Docs 料金ページ)。
ただし、Hugging Faceの deepseek-ai オーガナイゼーションを確認しても、2026年8月22日時点でvision版に対応するウェイトリポジトリは見当たりません。V4系で公開されているのは DeepSeek-V4-Flash-0731、DeepSeek-V4-Pro-0813 などテキストモデルのみです(Hugging Face deepseek-ai)。今回はAPI限定の実験公開、というのが現在地です。
「テキストは同等」の中身──7項目中6項目が上、幅は−1.4〜+5.6
まず引っかかるのは、公式が「テキストは同等」と言いながら、自ら並べたテキスト系エージェント評価7項目のうち6項目で、既存のV4-Flash-0731より高い値が出ていることです。上回っているのは6項目、下回っているのはCybergymの1項目だけで、差の幅は−1.4から+5.6に収まります。
公式リリースのベンチマーク表(画像)から、テキスト系エージェント評価の7項目を並べると次のようになります。
| ベンチマーク | V4-Flash-Vision-Exp | V4-Flash-0731 | 差 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | +1.2 |
| NL2Repo | 57.7 | 54.2 | +3.5 |
| Cybergym | 75.3 | 76.7 | −1.4 |
| DeepSWE | 59.3 | 54.4 | +4.9 |
| Toolathlon-Verified | 75.9 | 70.3 | +5.6 |
| DSBench-Hard | 63.6 | 59.6 | +4.0 |
| AutomationBench (Public) | 25.7 | 25.1 | +0.6 |
(DeepSeek API Docs 公式ベンチマーク表より。なおChange Logの本文に載っているのは9項目で、CybergymとToolathlon-Verifiedは本文にはなく、この画像にだけ出てきます)
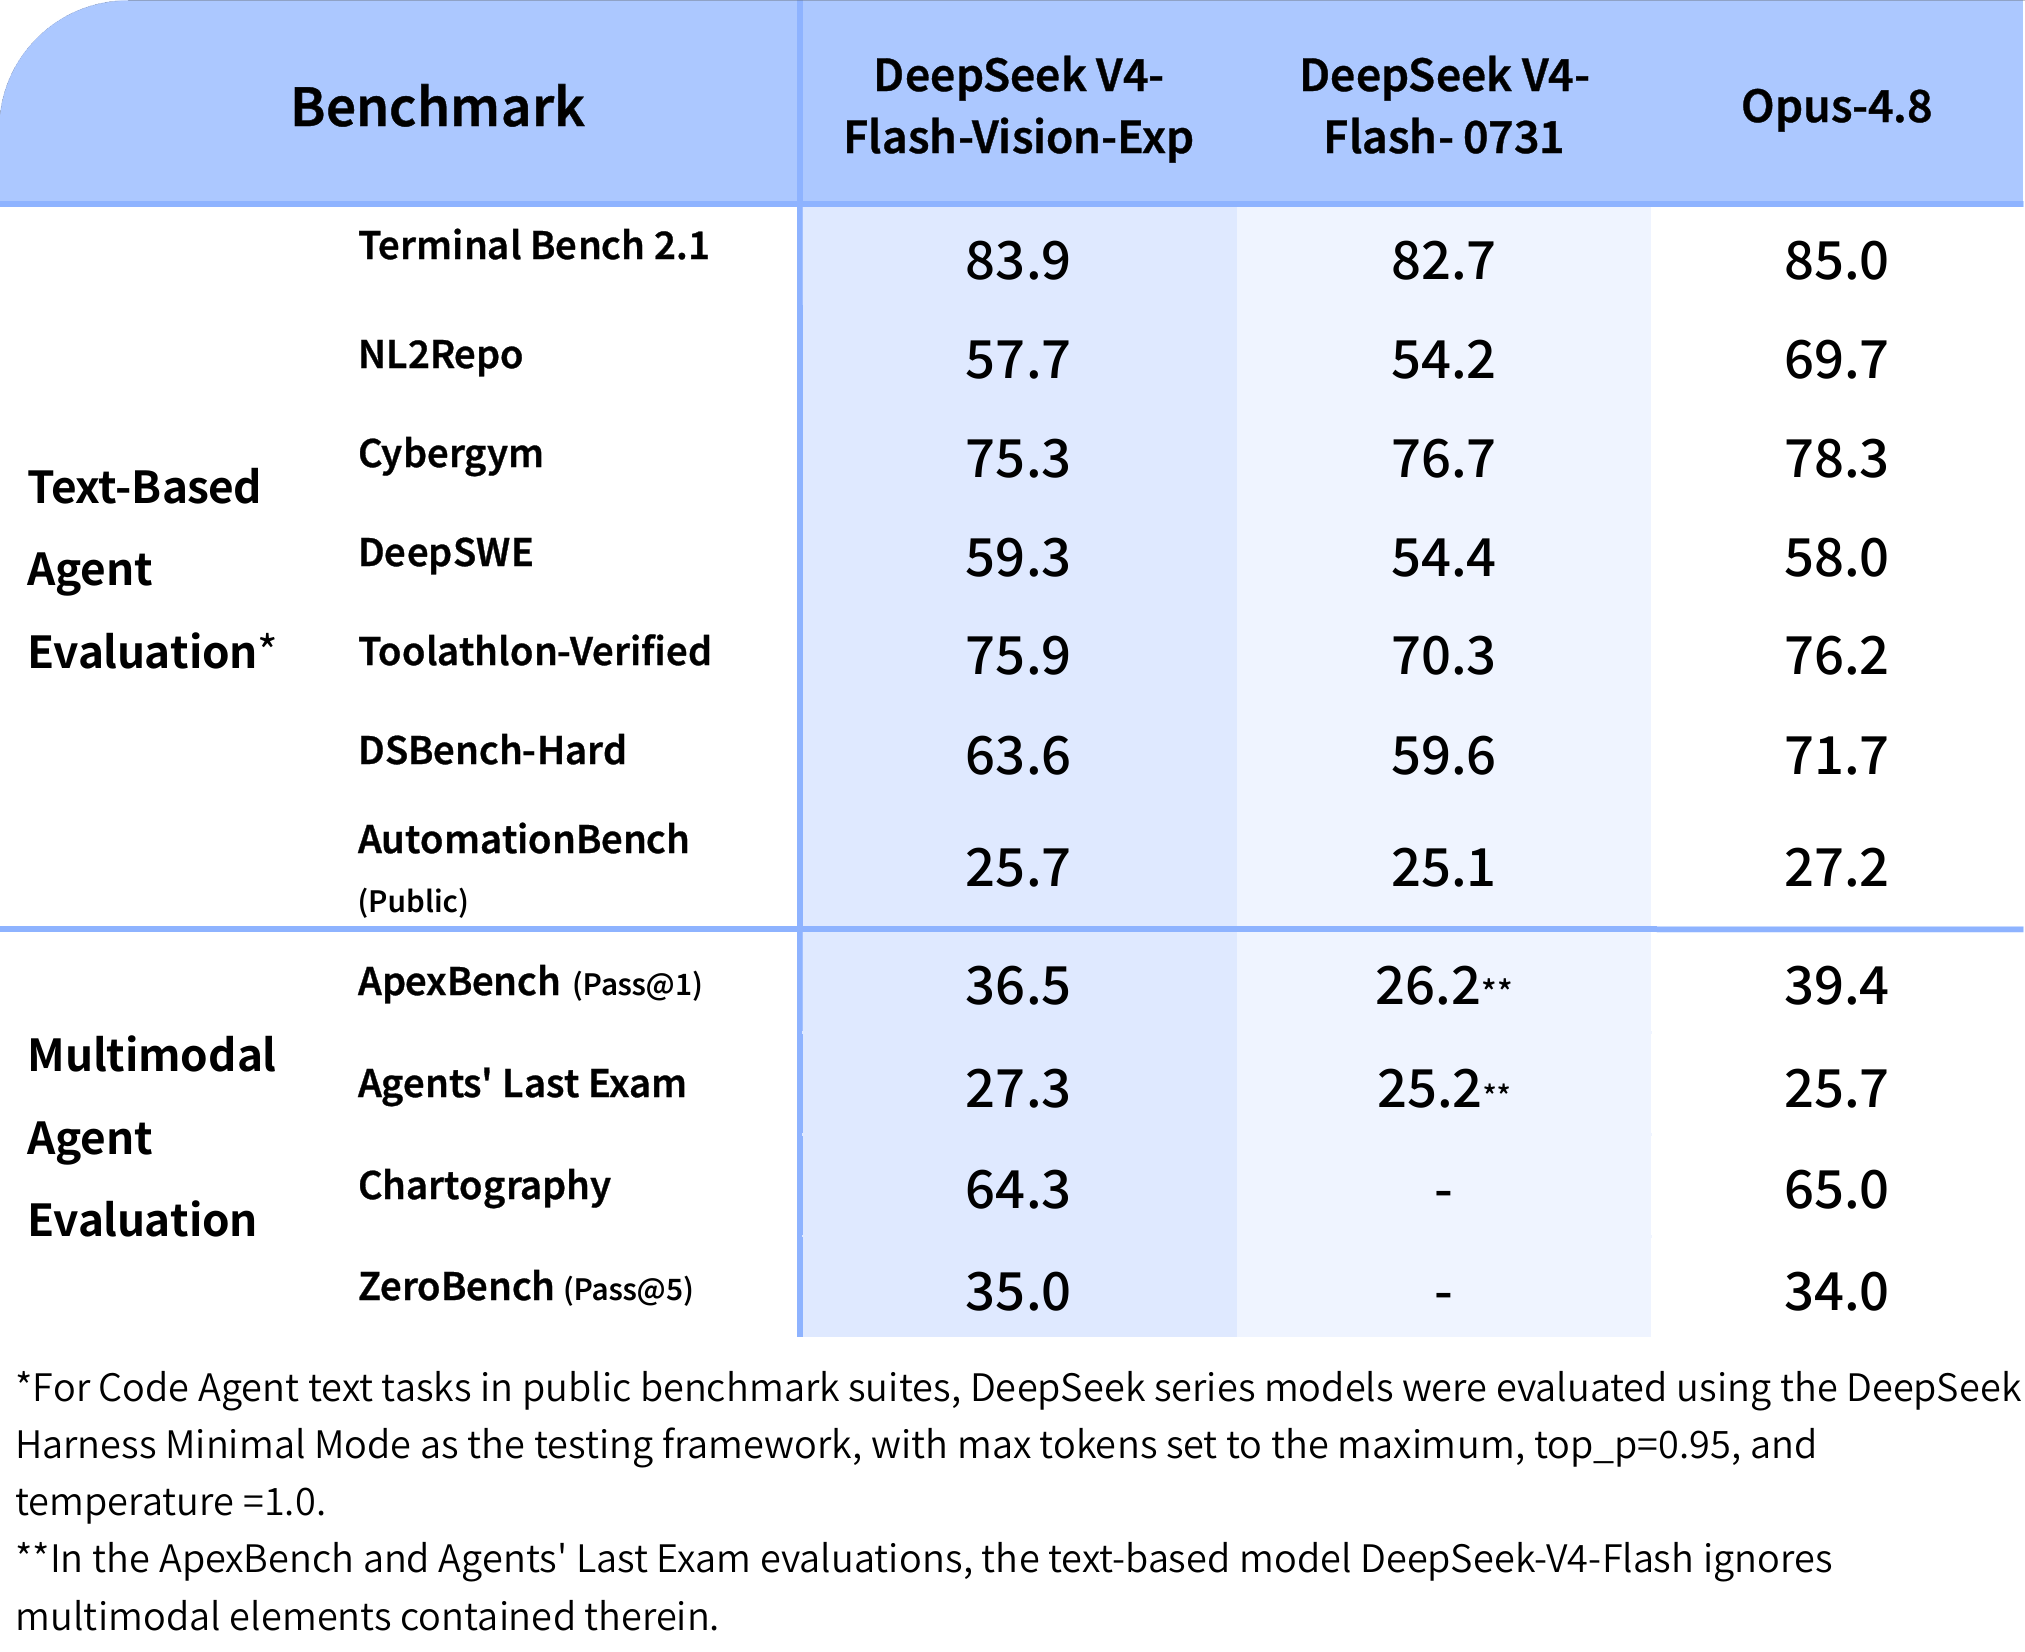
「同等」という表現は、この7項目に関しては控えめすぎます。伸び幅が最大なのはToolathlon-Verifiedの+5.6で、次いでDeepSWEの+4.9、DSBench-Hardの+4.0が続きます。
ここで測定条件を確認しておきます。Change Logは今回のコードエージェント系評価について「DeepSeek Harnessのminimalモードをフレームワークとし、max effort、top_p=0.95、temperature=1.0」で測ったと明記しています(DeepSeek API Docs Change Log 2026-08-21)。同じ脚注は公式ベンチマーク表の画像にも付いており、そちらは「max tokens set to the maximum」と書かれていて、effortとtokensで表記が異なります(DeepSeek API Docs 公式ベンチマーク表)。Harnessが0.1.1へ上がったタイミングと重なるため、ハーネス側の影響という可能性は残ります。ただし公式表は0731とVision-Expを同一の表・同一の脚注の下に並べており、表の体裁としては同条件での測定を示唆しています。
もうひとつ、DSBench系の扱いには注意が要ります。V4-Flash-0731のモデルカードにはDSBench-FullStack 68.7とDSBench-Hard 59.6の両方が載っており、今回のDSBench-Hard 63.6は同一サブセット同士で比較すると+4.0ポイントにあたります(Hugging Face DeepSeek-V4-Flash-0731、DeepSeek API Docs Change Log 2026-08-21)。FullStackの68.7とHardの63.6を並べて「下がった」と読むのは、別サブセットの混同になります。
視覚側のスコアはOpus-4.8とどう並ぶか
公式リリースのベンチマーク表は、テキスト系とは別に「Multimodal Agent Evaluation」という区分で4項目を掲載しています(DeepSeek API Docs 公式ベンチマーク表)。
| ベンチマーク | V4-Flash-Vision-Exp | V4-Flash-0731 | Opus-4.8 | 差(対Opus-4.8) |
|---|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2** | 39.4 | −2.9 |
| Agents’ Last Exam | 27.3 | 25.2** | 25.7 | +1.6 |
| Chartography | 64.3 | − | 65.0 | −0.7 |
| ZeroBench (Pass@5) | 35.0 | − | 34.0 | +1.0 |
V4-Flash-0731の列にある「−」は、その項目の値が公式表に載っていないことを示します。ApexBenchとAgents’ Last Examに付いた「**」は脚注の印で、「ApexBenchとAgents’ Last Examの評価では、テキストモデルのDeepSeek-V4-Flashは問題に含まれるマルチモーダル要素を無視する」と説明されています。この2項目の0731側の値は、画像を見ないまま解いたベースラインとして読む必要があります。
なお、この表の数値はいずれもDeepSeek自身の測定であり、第三者による検証ではありません。
読み方としては、公式区分のマルチモーダル4項目でOpus-4.8に2勝2敗、という形です。Agents’ Last Examが+1.6、ZeroBench (Pass@5)が+1.0で上回り、ApexBench (Pass@1)が−2.9、Chartographyが−0.7で下回っています。一方、テキスト主体のNL2Repoでは57.7対69.7で12ポイント差が残っています。「Opus-4.8に迫る」という公式の表現は、マルチモーダル区分に限れば妥当な範囲に見えますが、コード生成を含む総合力の主張としては読めません。
価格据え置きと無料Files API──API設計側の意味
料金ページで deepseek-v4-flash-vision-exp は deepseek-v4-flash と同じ単価帯に置かれています。ピーク時でキャッシュミス入力 0.44ドル/1M、出力 1.32ドル/1M、キャッシュヒット入力 0.014ドル/1M。オフピークはその半額で、ピーク時間帯はUTC 01:00–04:00 と 06:00–10:00 と定義されています。コンテキストは1M、最大出力は384Kです(DeepSeek API Docs 料金ページ)。OpenRouterの掲載値も入力 0.44ドル/1M・出力 1.32ドル/1M・キャッシュ読み出し 0.014ドル/1M、コンテキスト1,048,576トークンで一致しています(OpenRouter)。
画像の課金は、公式リリースが「画像は課金のためにトークン化され、1枚あたり最大384トークン、V4-Flash価格で計算する」と明記しています(DeepSeek API Docs 2026-08-21)。Visionガイドによれば、およそ384×384px未満の画像はアップスケール、大きい画像はアスペクト比を保ったまま約800×800pxへダウンスケールされるため、元解像度によらず1枚384トークンが上限になります。detail フィールドを low にすると512×512へ縮小され、さらに安く速くなります(DeepSeek API Docs Visionガイド)。
同ガイドは1リクエストあたり最大600枚という上限も示しています。上限まで画像を詰めた場合の入力トークン数と概算コストは次のとおりです。
$$ T_{\text{img}} = 600 \times 384 = 230{,}400 \quad\text{tokens} $$$$ C_{\text{peak}} = \frac{230{,}400}{10^6} \times 0.44 \approx 0.101 \;\text{USD} $$オフピークならこの半分、約0.051ドルです。1Mコンテキストのうち約23%を600枚の画像が占め、残り約77%をテキストに使える計算になります。画像を大量に読ませるエージェント用途で、コンテキスト側もコスト側も破綻しにくい設計です。
Files APIが無料であることは、この文脈で効いてきます。同じ画像を複数リクエストで参照する場合、file_id 経由なら送信帯域を節約できます。サイズ上限はbase64・外部URL経由で1枚32MiB、Files API経由で1枚64MiB、1リクエスト合計は file_id を使わない場合64MiB、使う場合200MiBです。加えて、base64や file_data で本文に埋め込むインライン画像は、リクエスト本文そのものの上限である48MiBにも従います(DeepSeek API Docs Visionガイド)。ただしトークン課金自体は参照のたびに発生するため、無料なのは保管と再アップロードの手間の部分だと読むべきです。
制約もいくつか明示されています。Chat Completionsでは画像をuserメッセージにのみ置けて、systemやassistantメッセージに入れると400エラーが返ります。Responses APIでは画像は input_image パートとして扱われ、user/developerメッセージに加えて function_call_output や custom_tool_call_output の出力にも置けますが、system/assistantメッセージが400で拒否される点は同じです。また、vision対応モデル以外に画像を渡すとエラーになります。対応フォーマットはJPEG、PNG、GIF、WebPで、判定は拡張子ではなく実際のファイル内容に基づきます(DeepSeek API Docs Visionガイド)。
ウェイトは出ていない
DeepSeekのV4系はこれまでウェイトを公開してきました。DeepSeek-V4-Flash-0731 はMITライセンスで、DSpark投機的デコーディングモジュールを同梱した304Bパラメータのモデルとして公開されています(Hugging Face DeepSeek-V4-Flash-0731)。
今回のvision版については、Hugging Faceの deepseek-ai 配下にそれらしいリポジトリが見当たりません。V4関連で並んでいるのは DeepSeek-V4-Pro-0813、DeepSeek-V4-Flash-0731、DeepSeek-V4-Flash-DSpark、DeepSeek-V4-Pro-DSpark などで、名称に Vision を含むものはありません(Hugging Face deepseek-ai)。公式リリースもウェイト公開には触れていません。
モデル名の末尾にある -exp は、Change Logが明示的に「experimental model」と説明しているとおり実験版を意味します(DeepSeek API Docs Change Log 2026-08-21)。8月13日にはV4-ProのGA版と8月16日発効の価格改定が告知されており、DeepSeekが安定版と実験版を明確に分けて出していることが分かります(DeepSeek API Docs Change Log)。ローカル運用を前提に検討するなら、現時点で触れるのはAPIだけ、という理解が要ります。
残された不確実性
ベンチマークは確認できる範囲でDeepSeekの自社公表値です。 Change Logの本文に載っているのは9項目ですが、公式リリースのベンチマーク表画像は11項目あり、CybergymとToolathlon-Verifiedは画像にしか出てきません。測定条件は画像の脚注に示されており、公開ベンチマーク集のコードエージェント系テキストタスクについては、DeepSeek系モデルはDeepSeek Harness Minimal Modeをテストフレームワークとし、max tokensを最大値、top_p=0.95、temperature=1.0で測定した、と書かれています。マルチモーダル系項目については、ApexBenchとAgents’ Last Examで比較対象のテキストモデルDeepSeek-V4-Flashが問題中の画像要素を無視する旨の脚注があるにとどまり、それ以外の測定条件は公開されていません(DeepSeek API Docs 公式ベンチマーク表、DeepSeek API Docs Change Log 2026-08-21)。外部機関の再現報告は2026年8月22日時点で確認できていません。
テキスト系の上振れの原因が特定できません。 Terminal Bench 2.1 +1.2、NL2Repo +3.5、DeepSWE +4.9、Toolathlon-Verified +5.6という差が、モデル自体の変化なのか、Harness 0.1.1という評価フレームワーク側の変化なのか、公開情報からは断定できません。ハーネス側の可能性は残りますが、公式表が0731とVision-Expを同一表・同一脚注の下に並べている以上、表の体裁はその説を支持していません。「テキストは同等」という説明とこの差の関係も、公式には説明されていません。
パラメータ数の記述が資料間で一致しません。 Hugging FaceのV4-Flash-0731モデルカードは304Bと記載する一方、OpenRouterはvision版の説明で総パラメータ284B・活性13Bと書いています。ただし284B・13BはOpenRouterという第三者プラットフォームの記載であり、DeepSeek公式が確定値として公表したものではありません。両者が同じ対象を指しているのか、vision版でアーキテクチャが変わったのかは不明です。
ウェイト公開の予定は示されていません。 過去にV4-Flashのウェイトが公開された事実は、vision版も公開されることを意味しません。GLM-5.3のケースのように安全性評価を挟んで遅れて出る例もあれば、API限定のまま終わる例もあり得ます。
実験版の継続性が保証されていません。 2026年8月21日の公式リリースノートおよびAPI Docs Change Logの該当エントリには、-exp 付きモデルの提供期間や、正式版へ移行する際にモデルIDが変わるかどうかの記載は見当たりません(DeepSeek API Docs 2026-08-21、DeepSeek API Docs Change Log 2026-08-21)。
まとめ
DeepSeekが2026年8月21日に出した deepseek-v4-flash-vision-exp は、V4-Flashと同じ単価・同じ1Mコンテキストのまま画像入力を足した実験版です。1枚最大384トークン、1リクエスト最大600枚、Files APIは無料という組み合わせは、画像を多く読むエージェント用途を明確に想定した設計に見えます。
一方で、公式の「テキストは同等」という説明と、公式のテキスト系エージェント評価7項目のうち6項目が上振れしている事実(差の幅は−1.4〜+5.6)は噛み合っていません。差の出どころがモデル側なのか評価ハーネス側なのかは公開情報では断定できず(公式表の体裁はハーネス差説を支持していません)、公表されている数値は確認できる範囲ではDeepSeek自身の測定によるものです。そしてウェイトは現時点で公開されていません。
API上で試せることと、手元で検証できることは別です。今回は前者だけが提供された、というのが正確な整理になります。
主要出典
- DeepSeek API Docs — Change Log(2026-08-21エントリ確認):
deepseek-v4-flash-vision-expの追加、experimental明記、9項目(本文)のベンチマーク値、評価条件(Harness minimalモード、max effort、top_p=0.95、temperature=1.0) - DeepSeek API Docs — 公式ベンチマーク表(画像)(2026-08-22閲覧):11項目(画像)の数値、テキスト系エージェント評価7項目とマルチモーダルエージェント評価4項目の区分、Opus-4.8列、測定条件の脚注(Harness Minimal Mode、max tokensは最大、top_p=0.95、temperature=1.0)
- DeepSeek API Docs — DeepSeek-V4-Flash-Vision-Exp リリース告知(2026-08-21):Opus-4.8への言及、画像1枚最大384トークン・V4-Flash価格、Files API無料、Harness 0.1.1対応
- DeepSeek API Docs — Visionガイド(2026-08-22閲覧):対応フォーマット、サイズ上限(リクエスト本文48MiBを含む)、600枚制限、
detailパラメータ、画像を置けるメッセージ種別の制約(Chat Completionsはuserのみ、Responses APIはuser/developerとツール出力) - DeepSeek API Docs — 料金ページ(2026-08-22閲覧):vision-expがv4-flashと同一単価、ピーク時間帯UTC 01:00–04:00と06:00–10:00、コンテキスト1M・最大出力384K
- Hugging Face — deepseek-ai/DeepSeek-V4-Flash-0731(2026-08-22閲覧):MITライセンス、304Bパラメータ、DSBench-FullStack 68.7とDSBench-Hard 59.6の併記
- Hugging Face — deepseek-ai モデル一覧(2026-08-22閲覧):vision版ウェイトリポジトリが存在しないことの確認
- OpenRouter — DeepSeek V4 Flash Vision Exp(2026-08-22閲覧):第三者プラットフォーム側の掲載単価とコンテキスト長
- the-decoder(2026-08-21):リリースの海外報道、オープンウェイトへの言及なし
関連する過去記事
- ベース744B-A40Bは据え置きでDeepSWEは46.2→66.9──GLM-5.3のウェイト公開は安全性評価後の約2週間後:同じ中国系ラボが「ベースは据え置き」と説明したケースと、ウェイト公開が遅れる理由の整理です。
- DeepSWE 49.0→65.3を3週間で──Gemini 3.7 Flashの導入価格は12月31日で終わり、1月1日に単価が2倍になる:Flash系モデルのベンチ改善と価格設定を扱った回で、今回の価格据え置きと対比できます。
- 『Qwenが1位』は同じ日に消えた──Agentic Indexの55.4対55.3が59.2対58.4に反転した日:評価フレームワーク側の変更でスコアが動く問題を扱った回です。