
何が起きたのか
Z.ai が 2026-08-26 に GLM-5.3-Flash を公開しました。総パラメータ320B・活性18Bの MoE(Mixture-of-Experts、トークンごとに一部の専門家だけを動かす方式)で、ライセンスは MIT、ウェイトは Hugging Face の zai-org/GLM-5.3-Flash に置かれています。モデルカードには「With 320B total parameters and just 18B active parameters」と明記されています。
同時に、OpenRouter と OpenCode へ提供元を伏せて投入され話題になっていた ox-alpha が、このモデルのプレビュー版だったことが公式に認められました。Z.ai 公式ドキュメントは「we tested GLM-5.3-Flash anonymously as ox-alpha on OpenCode and OpenRouter to gather user feedback」と書いています(Z.ai 公式ドキュメント)。TechCrunch も Z.ai が Ox Alpha の開発元であることを認めたと報じていますが、同記事が引いている確認は Bloomberg News の取材に対する Z.ai の回答であり、TechCrunch が独自に取ったものではありません(TechCrunch 2026-08-26)。Z.ai 公式アカウントの発表投稿も「Previously previewed as Ox Alpha, running entirely on Chinese AI chips」と書いており、匿名プレビューと自社の関係、および中国製AIチップ上での運用を明言しています(Z.ai 公式X 2026-08-26)。
筆者が本稿で取り上げたいのは、話題性そのものではありません。公称値として掲げられている数字と、モデルカードの脚注に書かれた測定条件が、ベンチマークごとにばらばらだという点です。
公称1Mコンテキストと、ベンチマークごとに違う評価条件
公式発表と各所の紹介文が揃って掲げているのは「1M-token context window」です。設定ファイル側にも対応する値があります。Hugging Face の config.json では設定上の最大長 max_position_embeddings が 1,048,576 で、$2^{20}$ ちょうどです。これは実装が受け付ける上限の宣言であって、その長さで測った品質を示す値ではありません。
では評価は何トークンで行われたのか。モデルカードの脚注は、ベンチマークごとに別々の条件を書いています(README raw)。
- HLE(ツール併用): 「The evaluation is conducted with a maximum context length of
300,000tokens, using a context management strategy.」 - DeepSWE: 400K コンテキスト
- NL2Repo: 「We evaluated NL2Repo with temperature=1.0, top_p=1.0, and max_new_tokens=64k under 1M context」
- BabyVision: 「a maximum context length of 164K tokens」
- Terminal-Bench 2.1: コンテキスト長の記載はなく、「We evaluate in Claude Code 2.1.207」とハーネスだけが書かれています
つまり「公式評価の上限は30万トークン」という読み方は成立しません。300K は HLE に付いた条件です。公称1Mに対する比率は
$$\frac{300{,}000}{1{,}048{,}576} \approx 0.286$$で約29%になりますが、この数字が説明するのは HLE 一つの測定条件であって、モデル全体の評価上限ではありません。164K も同様に BabyVision の脚注に書かれた条件で、公称の約16%にあたります。しかも「maximum context length」は上限の指定であり、各問題が実際にその長さを使ったことまでは意味しません。
残る不確かさは別のところにあります。README には文脈長に対する品質の劣化曲線が載っておらず、1M 条件での評価として明示されているのは NL2Repo だけです。1M 全域でどこから性能が落ちるのかを示す資料は、2026-08-27 時点で見つかっていません。長文脈で使う予定があるなら、公称1Mを額面どおり受け取るのではなく、自分のワークロードに近い長さで測り直す前提で考えるのが妥当です。
なお OpenRouter 上の掲載値は 1,310,720 トークンで、config.json の 1,048,576 とは一致しません(OpenRouter)。公称の「1M」は丸め表記なので config 側とは整合しますが、OpenRouter の値だけが25%大きく、これがどの条件を指すのかは公表されていません。
18B活性という分母:8/288と18/320は母集団が違う
MoE の「活性パラメータ」は、推論計算量の目安として使われます。実際の計算量はアテンションの方式、系列長、入力に画像を含むか、精度やキャッシュの扱いでも変わるため、あくまで粗い代理指標です。GLM-5.3-Flash の公称は 320B 中 18B 活性なので
$$\frac{18}{320} \approx 0.056$$約5.6%です。一方、config.json のルーティング設定を見ると、ルーテッド専門家は288個、トークンあたりに選ばれるのは8個、これに共有専門家が1個です。専門家だけで見た比率は
$$\frac{8}{288} \approx 0.028$$で約2.8%になります。ただしこの2つは同じ母集団の比率ではありません。8/288 はルータが選ぶルーテッド専門家の fan-out で、18/320 はモデル全体の活性/総パラメータ比です。後者にはアテンション、埋め込み、共有専門家、先頭側の dense 層、ビジョンエンコーダ、LM head などが入ります。公開資料に 18B の内訳がない以上、5.6% と 2.8% の差がどこから来ているかを厳密に分解することはできません。確実に言えるのは、MoE 層の疎さとモデル全体の疎さを同じ数字として扱うと読み違えるということです。
アーキテクチャ側も変わっています。config.json の layer_types を見ると、linear_attention 層が3層続くごとに deepseek_sparse_attention 層が1層挟まる 3:1 の繰り返し構成で、全45層のうちスパースアテンションは11層だけです。隠れ次元は4096、層数は45です(config.json)。モデルカードは「a hybrid architecture combining sparse and linear attention」と「Manifold-Constrained Hyper-Connections (mHC)」を挙げ、事前学習は30兆トークン規模のマルチモーダル事前学習コーパス(「a 30T-token multimodal pre-training corpus」)で行ったと説明しています(Hugging Face モデルカード)。学習規模もアーキテクチャの説明も Z.ai の公称であり、第三者が検証したものではありません。線形アテンションを混ぜる設計は長文脈のKVキャッシュ削減を狙ったものですが、その効果を長さ別に確かめられる公開データは、前節のとおり点在するだけです。
Terminal-Bench 2.1の84.3を、残余幅で見る
コーディング/エージェント系のスコアとして公表されているのは、Terminal-Bench 2.1 が 84.3、DeepSWE v1.1 が 63.4、HLE(ツール併用)が 55.3 です(Hugging Face モデルカード)。モデルカード自身は「approaching Claude Opus 4.8 on coding and agentic benchmarks」という言い方をしています。
比較表では、Terminal-Bench 2.1 の Claude Opus 4.8 が 85.0、GPT-5.6 Terra が 87.4、Gemini 3.7 Flash が 85.8 とされています(Z.ai 公式ベンチマーク画像、OfficeChai 2026-08-26)。Opus 4.8 との差は 0.7ポイントで、絶対値では小さく見えます。上限100までの残り幅に対する割合で見ると
$$\frac{85.0 - 84.3}{100 - 84.3} \approx 0.045$$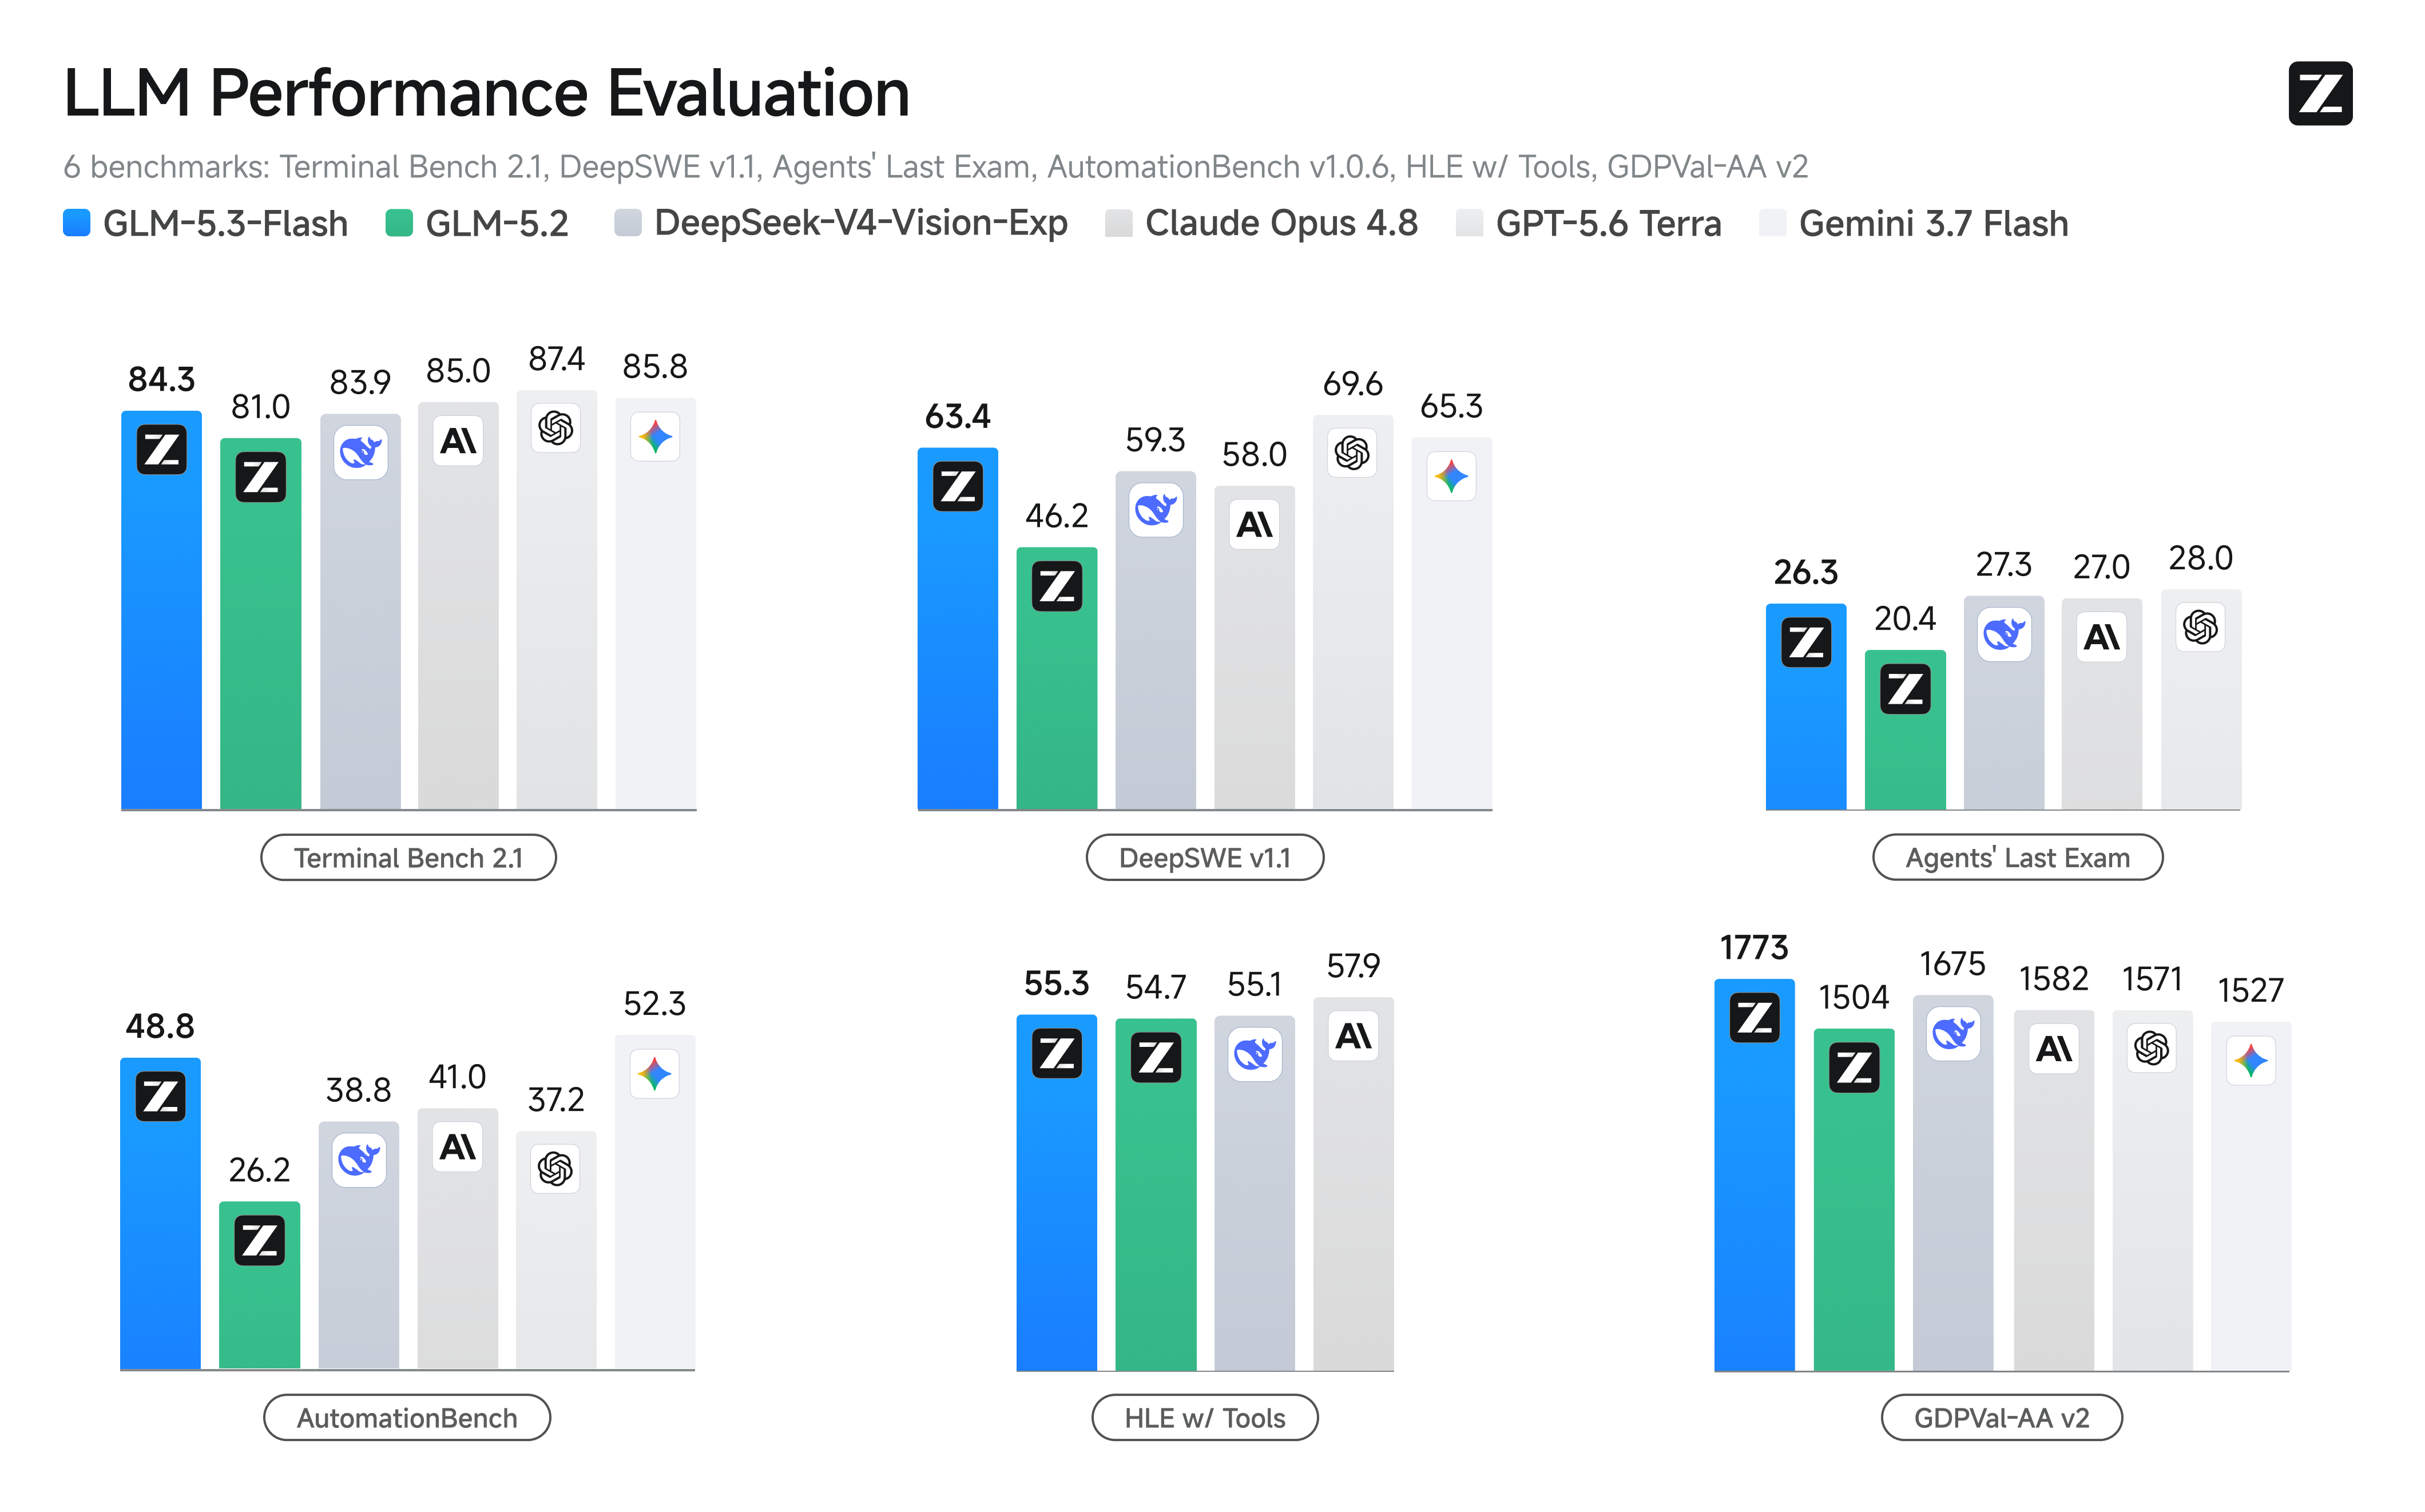
未達幅15.7ポイントのうち約4.5%、という言い換えになります。ただしこれは同じ差を別の分母で表しただけで、統計的な有意性を示すものではありません。Z.ai は Terminal-Bench 2.1 の反復回数も信頼区間も公表しておらず、0.7ポイントが測定のばらつきの内側か外側かは公開資料からは判定できません。Z.ai Code Bench v1.0 でも 29.0 対 Opus 4.8 の 29.5 と0.5ポイント差が報じられていますが、こちらは Z.ai 社内のベンチマークで、外部からの再現はできません。
自己報告の範囲も切り分けておきます。Terminal-Bench 2.1・DeepSWE v1.1・HLE の3値は、Z.ai がモデルカードに載せた自社測定値です。ただしモデルカード掲載値がすべて自社測定というわけではなく、脚注では GDPval-AA v2 について「Models are evaluated by Artificial Analysis」、Toolathlon Verified について「We obtain all results via the official evaluation service」と、評価主体を分けて書いています(README raw)。
第三者では Artificial Analysis が独立計測を行っており、Terminal-Bench v2.1 を含む9評価の合成指標 Intelligence Index で57を公表しています(Artificial Analysis)。合成指標の構成要素である以上、Terminal-Bench v2.1 単体の測定自体は実施されています。同社のTerminal-Bench v2.1 評価ページには GLM-5.3-Flash の値として84.27%が掲載されているとされますが、2026-08-27 時点で筆者が取得したページ本文は215モデル中30モデルまでの表示で、この数値を直接読み取れていません。仮にこの値だとしても、Z.ai の84.3と同条件の再現ではない点は押さえる必要があります。Artificial Analysis 側は「We run Terminal-Bench v2.1 with the Terminus 2 agent harness in an e2b sandbox and report pass@1 averaged over 3 repeats per task」、Z.ai 側は「We evaluate in Claude Code 2.1.207」で、エージェントハーネスが異なります。DeepSWE v1.1 は Intelligence Index の9評価に含まれておらず、独立再現値は 2026-08-27 時点で確認できていません。
もう一点、同じ GLM 系列内での比較も見ておく価値があります。本ブログが 2026-08-15 に扱った GLM-5.3(744B-A40B)は DeepSWE v1.1 で 66.9 でした。今回の Flash は 63.4 なので、フラッグシップより3.5ポイント低い位置にあります。総パラメータは 744B → 320B、活性は 40B → 18B とおよそ半分以下です。Flash は「上位互換」ではなく、規模を落として価格を下げた別ポジションのモデルとして読むのが妥当です。
前回は遅延した重みが、今回は同日MIT
8月中旬の GLM-5.3 では、ローンチ時点でウェイトは出ず、安全性評価とハードニング完了後(ローンチの約2週間後)に公開する方針が示されていました。今回の GLM-5.3-Flash は、発表と同じ 2026-08-26 に Hugging Face 上で MIT ライセンスのウェイトが利用可能になっています。TechCrunch も重み公開の予定を報じていました(TechCrunch 2026-08-26)。
同じベンダーの2週間差で、遅延公開と同日公開が並んだことになります。ただし両者はモデル規模もポジションも違うため、「方針が変わった」と断定できる材料は公開資料の中にはありません。フラッグシップ級には安全性評価後の遅延を、下位モデルには同日公開を、という運用の切り分けである可能性も残ります。
API 価格は入力 0.15ドル / 100万トークン、キャッシュ済み入力 0.03ドル、出力 0.50ドルです(Z.ai 公式価格表、OfficeChai 2026-08-26)。OpenRouter の掲載は50%割引が適用された入力 0.075ドル、キャッシュ読み出し 0.015ドル、出力 0.25ドルですが、これは恒久価格ではありません。OpenRouter のページには「Limited-time 50% discount via ZAI through September 9, 2026 at 16:00 UTC」と期限が明記されています(OpenRouter)。モデルカードの「one-tenth the price」という表現は GLM-5.2 との比較として書かれており、Opus 4.8 との価格比を主張したものではない点は区別しておきます。
「中国製AIチップ上で稼働」がカバーしている範囲
Z.ai 公式Xの文言は「running entirely on Chinese AI chips」です。あわせて、匿名プレビュー期間中の GLM-5.3-Flash は国産アクセラレータの大規模クラスタ上で、SGLang をベースにした自社推論エンジン(エンコード・プリフィル・デコードを分離する構成)によって提供され、同一ハードウェア上の初期ベースラインに対してエンドツーエンドで約3倍のサービング性能改善が得られた、と説明されています(Z.ai 公式ドキュメント)。
ここで確認しておくべきなのは、この主張が指しているのが推論(サービング)であって、学習まで含むとは書かれていないことです。プレビュー配信とその後のトラフィックを中国製アクセラレータで捌いたという主張と、モデルを中国製チップで学習したという主張は別で、後者は公開資料からは確認できません。チップの型番やベンダー名、クラスタ規模の具体値も公表されていません。「tens of thousands of domestic accelerators」という規模表現と3倍という改善幅は、いずれも Z.ai の一次資料に載っている自己申告で、第三者による監査や再現はありません。
なお、モデルカードにはチップに関する記述はなく、ローカル実行のフレームワークとして SGLang / vLLM / TokenSpeed / KTransformers が挙げられているだけです。手元で動かす側の目安になるのは GPU の枚数ではなく容量です。vLLM の公式レシピは既定の FP8 チェックポイントについて「about 306 GiB for the default native FP8 checkpoint before runtime and KV-cache overhead」と書いており、306GiB は実行時領域と KV キャッシュを含まない数字です。同レシピは GB200 1トレイでの TP4(テンソル並列4)構成を例示し、8GPU の例は「Split one 8-GPU node into a prefill pool (GPUs 0-3) and a decode pool (GPUs 4-7)」というプリフィル/デコード分離の別構成として載せています(vLLM recipe)。必要枚数は1枚あたりの VRAM 次第で、8枚が必須という条件ではありません。また config.json の量子化設定には modules_to_not_convert が並んでおり、全テンソルが FP8 というわけでもありません。
残された不確実性
- モデルカードの評価条件はベンチマークごとに違い(HLE 300K、DeepSWE 400K、NL2Repo 1M、BabyVision 164K、Terminal-Bench 2.1 は記載なし)、共通の上限はありません。一方で 1M 全域の品質劣化曲線を示す資料は 2026-08-27 時点で見つかっていません。
- OpenRouter の掲載コンテキスト長 1,310,720 と、config.json の 1,048,576 は一致していません。OpenRouter 側の値がどの条件を指すのかは公表されていません。
- Terminal-Bench 2.1 の 84.3、DeepSWE v1.1 の 63.4、HLE の 55.3 は Z.ai 自身の測定値です。比較対象(Opus 4.8 の85.0など)が同一の実行条件で測り直されたものかは、モデルカードからは判別できません。
- Artificial Analysis の Terminal-Bench v2.1 個別スコアは、評価ページの一覧が上位30モデルまでの表示のため、本稿執筆時点では直接確認できていません。DeepSWE v1.1 の独立再現値も見つかっていません。
- 「entirely on Chinese AI chips」が推論のみを指すのか学習を含むのかは明示されていません。本稿では推論についての主張として扱っています。
- ウェイトが同日公開された理由(安全性評価をどう通したか)は説明されていません。GLM-5.3 で示された「安全性評価とハードニング完了後」という方針との関係は不明です。
- Ox Alpha プレビュー期間中に測られたスコアと、正式版 GLM-5.3-Flash のスコアが同一かどうかも保証されていません。Z.ai の Zixuan Li 氏は X で「Ox Alpha は GLM-5.3-Flash の初期版であり、正式リリース版はより高い性能と大幅に改善された安定性を提供する」と投稿していますが、これは個人アカウントでの発言であり、企業としての公式声明ではありません(Zixuan Li 氏のX 2026-08-26)。
まとめ
GLM-5.3-Flash は、320B総/18B活性という MoE を MIT で同日公開し、Terminal-Bench 2.1 で Opus 4.8 との差を 0.7ポイントに詰めた、と自己報告しているモデルです。ここまでは公式資料で確認できます。
読み違えやすいのはその先です。公称1Mに対して、モデルカードの評価条件は HLE 300K、DeepSWE 400K、NL2Repo 1M、BabyVision 164K と分かれていて、全体を貫く上限はありません。「評価は300Kで打ち切られている」とも「1Mで測ってある」とも言えず、公開されているのは条件の違う点の集合です。活性18Bという分母も、ルーテッド専門家の 8/288 とモデル全体の 18/320 では母集団が違い、差を特定の部位に帰することは公開資料ではできません。中国製チップでの稼働という主張も、対象は推論側で、根拠は Z.ai の自己申告です。
数字の大きさよりも、その数字がどの分母・どの条件で測られたかを先に見る。今回の公開資料は、条件が脚注に分けて書かれているぶん、その突き合わせがしやすい部類です。
主要出典
- Hugging Face zai-org/GLM-5.3-Flash(2026-08-26 公開)— 公式モデルカード。320B総/18B活性、MIT、ハイブリッドアテンション、mHC、30Tトークン事前学習、Terminal-Bench 2.1=84.3 / DeepSWE v1.1=63.4 / HLE=55.3 の記載元
- zai-org/GLM-5.3-Flash README(raw)— ベンチマーク別の脚注。HLE「maximum context length of
300,000tokens, using a context management strategy」、DeepSWE 400K、NL2Repo「under 1M context」、BabyVision「164K tokens」、Terminal-Bench「We evaluate in Claude Code 2.1.207」、GDPval-AA v2「Models are evaluated by Artificial Analysis」、Toolathlon Verified「the official evaluation service」の確認元 - zai-org/GLM-5.3-Flash config.json—
max_position_embeddings1,048,576、45層、ルーテッド専門家288+共有1、トークンあたり8専門家、FP8(e4m3)とmodules_to_not_convertを確認 - Z.ai 公式ドキュメント GLM-5.3-Flash— ox-alpha としての匿名テスト、1Mトークン文脈、中国製AIチップ上でのサービング(SGLangベース、EPD分離、数万アクセラレータ、3倍改善)の一次資料
- Z.ai 公式X 2026-08-26— 「320B-A18B / MIT / 1M-token context / Previously previewed as Ox Alpha, running entirely on Chinese AI chips」の一次表明
- Z.ai 公式ベンチマーク画像— Terminal-Bench 2.1 の比較値(Opus 4.8=85.0、GPT-5.6 Terra=87.4、Gemini 3.7 Flash=85.8)の一次資料
- Artificial Analysis GLM-5.3-Flash / Terminal-Bench v2.1 評価ページ— Intelligence Index 57(9評価の合成、独立計測)と、Terminus 2 ハーネス+e2b サンドボックスで3反復 pass@1 という評価方法
- vLLM recipe GLM-5.3-Flash— FP8チェックポイント約306GiB(実行時・KVキャッシュ別)、GB200 1トレイのTP4例、8GPUのプリフィル/デコード分離例
- TechCrunch 2026-08-26— Z.ai が Ox Alpha の開発元であると認めた事実(Bloomberg 取材への回答の引用)と、ウェイト公開予定の報道
- OfficeChai 2026-08-26— Terminal-Bench 2.1 の比較値と API 価格の報道
- OpenRouter GLM 5.3 Flash / Z.ai 公式価格表— 掲載コンテキスト長1,310,720、割引価格 0.075ドル/0.015ドル/0.25ドル と 2026-09-09 16:00 UTC という期限の確認
関連する過去記事
- ベース744B-A40Bは据え置きでDeepSWEは46.2→66.9──GLM-5.3のウェイト公開は安全性評価後の約2週間後、ExploitGymではMythos 5に大差 — 2週間前のフラッグシップ側。今回の同日MIT公開と、そちらの遅延公開が対になって読めます
- 『テキストは同等』のはずが7指標中6項目で上昇──DeepSeek V4-Flash-Vision-Expの価格据え置きとウェイト未公開 — 同じ中国系ベンダーのマルチモーダル拡張と、ウェイト公開/未公開の判断の比較
- 同点52は『互角』か──Qwen3.8-27BがGPT-5.6 Lunaと並んだ指数と、推奨4bitが17〜19GBで16GBカードに載らない話 — 僅差スコアをどう読むか、そして手元で動かす際の実サイズという同型の論点