
Googleは2026年11月9日、第8世代TPUに「TPU 8tx」と「TPU 8i Max」の2システムを追加しました。TPU 8txは学習向けのTPU 8tと同じシリコンに、ハードウェアの機密計算(confidential compute)を組み込んだ推論・小規模学習向けのシステムです。TPU 8i Maxは推論向けTPU 8iのチップを2つ1パッケージに載せ、演算・SRAM・HBM帯域を8iの2倍にしたものです(Google公式ブログ 2026-11-09)。
一方で、11月9日の公式ブログ本文には2機種の提供開始日・提供リージョン・価格の記載がなく、ITmediaも「具体的な提供開始日や料金は明らかにしていない」と報じています(ITmedia NEWS 2026-11-10)。提供の時期については、Bloombergの配信記事がVahdat氏の話として「来年(2027年)提供」と伝えています(Bloomberg配信記事 Deccan Chronicle 2026-11-09)。4月発表の8t・8iも、11月10日に確認したCloud TPUのリージョン表とリリースノートにはまだ載っておらず、東京・大阪で使えるかは判断できる材料がない状態です。
この記事でわかること
- 第8世代TPU 4種(8t・8i・8tx・8i Max)の役割分担と公表スペックを1枚の表で比べられる
- TPU 8txの機密計算が守る対象(使用中のデータとモデル重み)と、8t比で公表された性能差がわかる
- TPU 8i Maxで2倍になるものと、2倍にならないもの(HBM容量)を区別できる
- 提供開始日・東京/大阪リージョン・価格のうち、何が公表済みで何が未公表かを確認できる
- Nvidia GPUやAWS Trainiumとの比較で、公式資料から言えることと言えないことがわかる
1. 何が起きたか──第8世代TPUが1年で4システムに
発表したのは、GoogleのSVP兼AI・インフラ担当チーフテクノロジストのAmin Vahdat氏です。公式ブログ『Our newest TPUs: 8tx and 8i Max, built for the agentic era』(2026年11月9日)は、冒頭で「1年に4つのTPUシステムを出すのは今回が初めて」と書いています。原文は『This is the first time we have introduced four TPU systems in a single year.』です。
4月のGoogle Cloud Next(Bloombergの2026年4月22日の記事『Google Cloud Debuts New AI Chips, Tools for Building Agents』が報じた発表)で、Googleは学習向けのTPU 8tと推論向けのTPU 8iを出していました。今回の2機種はその派生で、新しいチップ設計ではありません。11月のブログは4種の役割を次のように1文で並べています。
- TPU 8t: 大規模な学習(scale-up training)
- TPU 8i: 低レイテンシの推論(low-latency reasoning)
- TPU 8tx: 機密計算(confidential computing)
- TPU 8i Max: 巨大なコンテキストウィンドウと、ラックあたり最高の演算密度
日本語の報道では、ITmedia NEWSが11月10日に『Google、第8世代TPUに「8tx」と「8i Max」を追加 機密データ処理と大規模AIエージェントに特化』として伝えています(ITmedia NEWS 2026-11-10)。本記事の数字は、すべてGoogleの公式ブログとCloud TPUのドキュメントから取り直しました。
2. 一次資料の対応表
本記事は実機での測定をしていません。性能値はすべてGoogleの公称値です。根拠にした資料を先に示します。
| 主張・数字 | 一次資料 | 種別 | 確認日 |
|---|---|---|---|
| 8tx・8i Maxの発表、1年に4システムは初 | Google公式ブログ(2026-11-09) | 公式ブログ | 2026-11-10 |
| 8tx: 8tと同じシリコン、第5世代AMD EPYCホスト、Boardfly、8t比最大2倍の低レイテンシ | 同上 | 公式ブログ | 2026-11-10 |
| 8i Max: 8iを2チップ1パッケージ、演算・SRAM・HBM帯域が2倍 | 同上 | 公式ブログ | 2026-11-10 |
| 8t: 9,600チップ・HBM 2PBのスーパーポッド、121 ExaFlops | Google公式ブログ(2026年4月、Cloud Next) | 公式ブログ | 2026-11-10 |
| 8i: HBM 288GB・SRAM 384MB、ドルあたり性能80%向上 | 同上 | 公式ブログ | 2026-11-10 |
| 8t・8iは「年内にGA」予定 | 同上 | 公式ブログ | 2026-11-10 |
| TPUのリージョン表に第8世代の記載なし、東京はv6eのみ | Cloud TPU リージョンとゾーン | 公式ドキュメント | 2026-11-10 |
| リリースノートの最新項目は2026年6月1日、第8世代の記載なし | Cloud TPU リリースノート | 公式ドキュメント | 2026-11-10 |
3. 第8世代TPU 4種の比較表
公式ブログ2本の本文に書かれた内容を中心に表を作りました(ネットワークの2行は4月の技術解説によります)。4月のブログにはスペック表の画像もありますが、本文テキストに出てこない値は「記載なし」としています。Google Cloudの比較表画像には8tx・8i Maxの値も載っており、8i Maxの主な値は5章で紹介します。
| 項目 | TPU 8t | TPU 8i | TPU 8tx | TPU 8i Max |
|---|---|---|---|---|
| 発表 | 2026年4月 | 2026年4月 | 2026年11月9日 | 2026年11月9日 |
| 主な用途 | 大規模学習 | 低レイテンシ推論 | 機密推論・小規模学習 | 長いコンテキストの推論・高密度 |
| シリコン | 8t | 8i | 8tと同じ | 8iを2チップ1パッケージ |
| ホストCPU | Axion(Arm) | Axion(Arm) | 第5世代AMD EPYC | 記載なし |
| チップ間接続(ICI)の構成 | 3D torus | Boardfly | Boardfly | 記載なし |
| データセンター網(スケールアウト用) | Virgo Network | 記載なし | 記載なし | 記載なし |
| メモリ | スーパーポッドでHBM 2PB | HBM 288GB、SRAM 384MB | 記載なし | SRAMとHBM帯域が8iの2倍 |
| 規模 | 1スーパーポッド9,600チップ | 4チップ×8ボード×36グループの構成図 | 記載なし | 記載なし |
| 公称性能 | 前世代比でポッドあたり演算性能が約3倍 | 前世代比でドルあたり性能80%向上 | 8t比で最大2倍の低レイテンシ | 8i比で演算2倍 |
| 提供時期 | 年内にGA予定(4月時点) | 年内にGA予定(4月時点) | 記載なし | 記載なし |
8iの規模欄は、4月のブログの構成図の説明「4チップの全結合を8ボードでつなぎ、それを36グループ全結合して1ポッドにする」をそのまま書いたものです。Googleは4月の技術解説で、最大1,152チップを接続し、そのうち稼働するのは36グループで最大1,024チップと説明しています(Google Cloud公式ブログ 技術解説)。
ネットワークは、階層の違う2行に分けて書きました。チップ同士をつなぐ接続(ICI)の構成は、8tが3D torus、8iがBoardflyです。4月の技術解説は8tについて『utilizes our proven 3D torus network topology』と書き、8iについては同じ1,024チップのポッドで経由するホップ数の上限が16から7に減る(『reduces the network diameter from 16 hops down to just seven』)と説明しています。Virgo Networkはこれとは別の層で、8tのチップ群を束ねるデータセンター網です。技術解説は『Virgo Network is a scale-out fabric』と書いており、8iについてはデータセンター網の名前を挙げていません。8txについても、11月のブログに書かれているのはBoardflyの採用だけで、データセンター網の名前は挙がっていません(Google Cloud公式ブログ 技術解説)。
8tの性能値には、資料によって表現の揺れがあります。4月のブログは『nearly 3x the compute performance per pod』(ポッドあたり演算性能が前世代の約3倍)と書いています。11月のブログは8tと8iを振り返り、『up to 2.7 times better training performance and 80% better inference price performance』と書いています。11月のブログの表現では、2.7倍は8tの学習性能、80%は8iの推論の価格性能を指しています。4月のブログは、前世代をIronwood(第7世代)と明記したうえで、8tと8iの電力あたり性能を「最大2倍」としています。
4. TPU 8txの機密計算は何を守るのか
守る対象は「使用中」のデータとモデル重み
11月のブログはまず前提として、データは保存時や通信時には暗号化されるが、計算中はメモリ上で復号しなければならない、と説明しています。TPU 8txはこの「使用中」の段階を守るために、セキュリティをハードウェア層に組み込んだシステムです。原文は『keeping sensitive data and model weights protected and isolated even while in active use』で、保護対象は機密データとモデル重みの2つです。
想定する利用者について、ブログは『regulated enterprises and governments running frontier or proprietary models and autonomous agents alongside their most sensitive data』と書いています。規制下の企業や政府が、最先端または自社独自のモデルやエージェントを、機密データと同じ環境で動かす場面です。
用途としては推論のほかに次の3つが挙がっています。
- 自社の非公開データでのファインチューニング
- 大きなモデルから小さなモデルへの蒸留
- 強化学習によるエージェントの訓練
ブログはこれらを、機密データを別クラスタに移さずに実行できるとしています。
8tとの違い
| 項目 | TPU 8t | TPU 8tx |
|---|---|---|
| シリコン | 8t | 8tと同じ |
| ホストCPU | Axion | 第5世代AMD EPYC |
| チップ間接続(ICI)の構成 | 3D torus | Boardfly(8iと同じ低レイテンシ網) |
| レイテンシ | 基準 | 8t比で最大2倍低い(公称) |
| 機密計算の性能低下 | ― | 『near-zero performance penalty』(公称) |
8tのチップを使いながら、チップ間の接続を8tの3D torusではなく、8iと同じ低レイテンシのBoardflyにしている点が、8txの構成の要点です。学習向けの8tより推論のレイテンシを下げ、機密計算のオーバーヘッドはほぼゼロとしています。いずれもGoogleの公称値で、第三者の測定はまだ出ていません。
ホストCPUは、8t・8iの特徴として4月に強調されたGoogle独自のAxionではなく、AMDの第5世代EPYCです。11月のブログの本文からは、機密計算の具体的な方式(CPU側のどの機能を使うか、TPUのメモリをどう暗号化するか、リモート認証の仕組み)は確認できず、ホストが第5世代AMD EPYCであることと、ハードウェア層でデータを保護するという説明にとどまります(Google公式ブログ 2026-11-09)。
一方、AMDの同日の発表は、EPYCのSecure Encrypted Virtualization(SEV)機能を使い、アクセラレータの識別情報とセキュリティ構成を確認してから保護メモリへのアクセスを認めることで、プロンプト・モデル重み・中間データをCPUメモリ上とホスト・アクセラレータ間の通信で暗号化したままにすると説明しています(AMD Newsroom 2026-11-09)。TPU側のメモリの暗号化範囲や、利用者が使えるリモート認証の手順は、確認した資料からはわかりません。
5. TPU 8i Maxは何が2倍になるのか
TPU 8i Maxについて、ブログは『built for a different problem: the memory wall』と書いています。対象はメモリの壁で、8iのチップ2つを1つのパッケージに載せています。2倍になると明記されたのは次の3つです。
- 演算性能(compute)
- SRAM
- HBM帯域
8iのSRAMは4月のブログで384MBとされているので、単純に倍にすると1パッケージ768MBになります。11月のブログ本文には8i Maxの絶対値もHBM容量も書かれていませんが、Google Cloudのロゴが入った仕様比較表(PC Watch掲載の画像)では、8i Maxのオンチップメモリ(VMEM)が768MB、HBM容量が384GB、HBM帯域が17.2TB/sとされています(比較表画像)。HBM容量は8iの288GBの約1.33倍で、2倍ではありません。
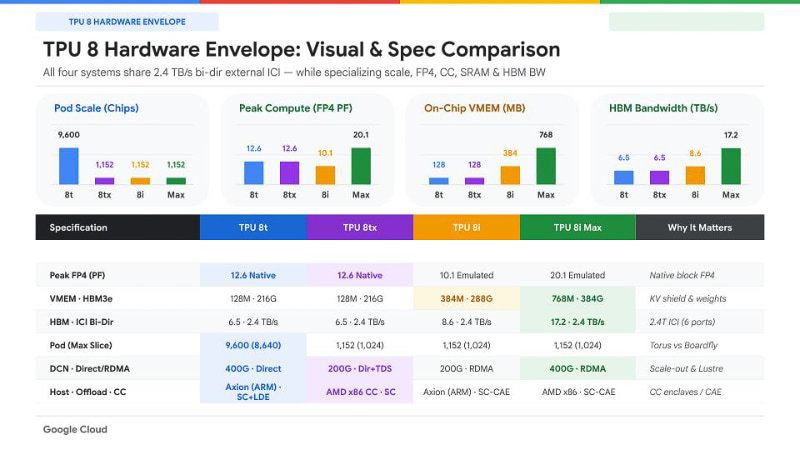
狙う用途としてブログが挙げるのは、数十のAIエージェントがコードベース全体や数時間分の動画を同時に扱う場面です。こうした処理ではメモリ帯域が先にボトルネックになる、という説明です。新2機種が解く課題は『million-token context scale』とも書かれており、100万トークン級のコンテキストを想定しています。
もう1つの特徴はラックあたりの密度です。8i Maxは既存のラックの設置面積(フットプリント)に2倍のシリコンを載せられるとされ、床面積あたり・電力あたりの演算量を増やせると説明されています。データセンターの床と電力が制約になっている事業者向けの説明です。
6. 背景と競合──Nvidia・Trainiumとの関係
Google側の文脈
11月のブログによると、TPUは「100社近い顧客」を持つ事業になっています。顧客の種類として、フロンティアラボ、トレーディング企業、小売、大学が挙がっていますが、社名は出ていません。4月のブログでは、Citadel SecuritiesがTPUを選んだ組織として名前が出ています。11月のブログには、TPUを顧客の自社データセンターに直接設置する形にも触れた一文があります。
ソフトウェア側では、11月9日のブログで次のものが併せて紹介されました(Google公式ブログ 2026-11-09)。
- Claude Code・Cursor・Google Antigravityなどのコーディングツールにつなぐオープンソースの「TPU agent suite」(プレビュー)
- オープンソースの推論エンジン「XLA Serving Engine」(11月5日に発表済みのもの)(Google Open Source Blog 2026-11-05)
- 「TPU Sync」のオープンソース化(11月9日のブログは、KV転送遅延とTTFT(最初のトークンが出るまでの時間)を90%超短縮すると説明)
- GKEでのCloud PathwaysとDynamic SlicingのGA
ここでGAやプレビューの段階が書かれているのはソフトウェアだけです。TPU 8tx・8i Maxのハードウェアには段階が書かれていません。
Nvidia GPU・AWS Trainiumとの比較
11月・4月のブログ本文からは、Nvidia GPUやAWS Trainiumとの性能・価格の比較は確認できず、比較は前世代TPU比です。11月のブログには、InferenceX・AgentXベンチマーク(リンク先はSemiAnalysis)で『state-of-the-art price-performance』を記録したとする記述がありますが、具体的な数値はありません(Google公式ブログ 2026-11-09)。
そのため「8txはNvidiaの何倍速い」「Trainiumより安い」と言える公式の根拠は、11月10日時点ではありません。公式資料から言える変化は、Google CloudのTPUの中に、機密計算を前提とした選択肢と、長いコンテキスト向けの高密度な選択肢が加わったという点までです。AWS側の動きとしては、Trainium向けのPyTorchバックエンドTorchNeuronの公開ベータを別記事で扱っています。
7. 日本の読者への影響──提供時期・リージョン・価格
提供時期と価格
| 項目 | TPU 8t / 8i | TPU 8tx / 8i Max |
|---|---|---|
| 提供時期 | 4月のブログで『generally available later this year』 | 11月のブログには記載なし(Bloombergの配信記事ではVahdat氏が「来年」と説明) |
| プレビュー・GAの段階 | 記載なし(11月10日時点でリリースノートにも項目なし) | 記載なし |
| 価格 | 記載なし | 記載なし |
| 提供リージョン | 記載なし | 記載なし |
| 問い合わせ窓口 | TPU関心登録ページ | 11月のブログには記載なし |
4月に「年内にGA」とされた8t・8iも、11月10日に確認したCloud TPU リリースノートでは、最新の項目が2026年6月1日のもので、第8世代の名前は出てきません。同ページで最も新しいTPUの記録は、TPU7x(Ironwood)の2025年11月24日プレビュー、2026年3月31日GAです。
東京・大阪リージョン
11月10日に確認したCloud TPU リージョンとゾーンのページで、日本のリージョンに載っていたのは次のとおりです。
- 東京(asia-northeast1): v6e(Trillium)のみ。ゾーンはasia-northeast1-b
- 大阪(asia-northeast2): TPUの記載なし
- TPU7x(Ironwood): us-central1のゾーンのみ
第8世代の4種はこの表に1つも載っていません。日本のデータを国外に出せない業務で8txの機密計算を使いたい場合、国内リージョンで提供されるかが前提になりますが、11月10日時点では判断できる公式情報がありません。
規制下のデータを扱う企業にとっての意味
金融や公共のように、データの所在や処理中の保護を説明する必要がある組織にとって、8txの説明が意味を持つのは、モデル重みと処理中のデータの両方をハードウェアで隔離するとしている点です。ただし、どの認証や規制基準に適合するか、Google Cloudのどのコンプライアンス文書の対象になるかは、11月のブログの本文からは確認できません(Google公式ブログ 2026-11-09)。導入を検討する場合は、提供リージョンと合わせて、Google Cloudの担当窓口に確認する項目になります。
8. 限界と未確定の点
- 性能値はすべてGoogleの公称値: 8txの「8t比最大2倍の低レイテンシ」と「性能低下ほぼゼロ」、8i Maxの「2倍」は、いずれも第三者の測定がまだありません
- 機密計算の方式は一部だけ公表: AMDはSEVの利用と、CPUメモリ上・ホストとアクセラレータ間の通信での暗号化を説明していますが、TPU側のメモリの暗号化範囲や利用者向けのリモート認証の手順は確認できていません
- 8i Maxの数値は資料によって扱いが違う: 11月のブログ本文には絶対値がなく、Google Cloudの比較表画像にHBM 384GB・オンチップメモリ768MBなどが載っています。消費電力は確認できていません
- 8tの倍率の揺れ: 4月は「ポッドあたり演算性能が約3倍」、11月は「学習性能が最大2.7倍」で、指標が違います
- 8t・8iの「年内GA」の進捗: 11月10日時点で、公式ドキュメントにGAの記録が見当たりません
- ドキュメントの更新遅れの可能性: リージョン表とリリースノートは、発表から遅れて更新されることがあります。本記事の「記載なし」は、11月10日に確認した時点の状態です
本記事は、8tx・8i Maxのプレビュー日またはGA日、提供リージョン(特に東京・大阪)、料金のいずれかがGoogle Cloudから公表された時点で更新します。
9. よくある質問
TPU 8txはTPU 8tと別のチップですか?
11月のブログでは『Built on the same silicon as TPU 8t』とされており、チップ自体は8tと同じです。違いは、ホストCPUが第5世代AMD EPYCであること、ネットワークが8iと同じBoardflyであること、ハードウェアの機密計算を備えることの3点です。
TPU 8i MaxはHBMの容量も2倍になりますか?
ブログが2倍と明記しているのは、演算・SRAM・HBM帯域の3つです。HBMの容量はブログ本文には書かれていませんが、Google Cloudの比較表画像では8i Maxが384GBとされています。8iの288GBの約1.33倍で、容量は2倍にはなりません。
日本で使えますか?
11月10日時点で、8tx・8i Maxの提供リージョンは公表されていません。Cloud TPUのリージョン表では、東京で提供されているTPUはv6eだけで、大阪には記載がありません。4月発表の8t・8iも同じ表にまだ載っていません。
価格はいくらですか?
4種とも、価格は公式ブログに書かれていません。公式ブログ本文にある価格に関わる相対値は、8iが前世代比でドルあたり性能80%向上というものです。
個人や小規模な開発者が触る方法はありますか?
ハードウェアの提供開始日が未公表のため、11月10日時点で第8世代TPUを使う公開の手段はありません。同日に発表されたTPU agent suiteはプレビュー段階で、11月9日のブログではClaude CodeやCursorなどにつなげるとされていますが、これはソフトウェア側の発表です。
10. 関連記事
- AmazonのTorchNeuronは何を書き換え不要にしたか──AWS Trainium側のソフトウェア対応の現状
- OpenAI Jalapeñoの『kWあたり』は公称TDPで正規化されている──自社推論チップの公称値を読むときの注意点
- MarvellのLumentum買収をSEC書類で読む──AIデータセンターの光インターコネクトをめぐる再編
11. まとめ
- Googleは2026年11月9日、第8世代TPUにTPU 8tx(機密計算つきの推論・小規模学習向け)とTPU 8i Max(8iの2チップ1パッケージ)を加え、1年で4システムになりました
- 8txは8tと同じシリコンで、使用中のデータとモデル重みをハードウェアで隔離し、8t比最大2倍の低レイテンシを公称しています
- 8i Maxは演算・SRAM・HBM帯域が8iの2倍で、100万トークン級のコンテキストとラックあたりの密度を狙っています
- 提供開始日・リージョン・価格は2機種とも未公表(Bloombergの配信記事ではVahdat氏が来年提供と説明)で、4月の8t・8iも11月10日時点で公式のリージョン表に載っていません。東京・大阪での利用を前提にした判断は、Google Cloudの公表を待つ必要があります